
致力于让每个想拥抱AI的人都能找到适合自己的AI产品,助力企业定制AIGC应用
Joined June 2022
- Tweets6.3K
- Following2K
- Followers38.3K
- Likes894





Pinned Tweet
又有人把谷歌的EmbeddingGemma 2玩出了新花样!做成了一个能实时学习的本地语义决策系统,CPU上就能实现毫秒级判断
文本22毫秒出一次判断,图片约100毫秒,每百万token成本不到3美分,本地运行
项目叫hunch,让大模型当老师,让本地小模型边用边学,逐渐接管大模型的高频判断任务
架构:EmbeddingGemma 2+轻量分类器+教师模型蒸馏
像工具调用是否失败、日志是否异常、用户意图属于哪一类、应该路由给哪个Agent,这些判断每次都调用大模型,既有延迟也会持续消耗Token
大模型先提供判断、充当老师,本地小模型持续学习,把重复任务接过去,复杂问题继续交给大模型,简单、高频、稳定的任务交给本地轻量模型
让AI的高频判断形成一个持续学习、逐渐降低成本的闭环,让小模型也能承担更有实际价值的任务
对Agent日志分析、工具调用监控、实时分类和任务路由,这种架构比较有潜力
#hunch #EmbeddingGemma2 #语义决策系统
uni-robot-agent:清华 × 伯克利一起做的开源机器人 Agent harness,给大模型llm套一层"壳",让它直接去指挥机器人干活,对标最近宇树和gpt-6 astra结合指挥机器人干活的路径。
1、没用仿真器真值,也没做蒸馏,就是用现成的开源模型 Qwen3.8-Flash-Next 往上一套harness。
2、开源模型反超闭源:RoboDojo 基准上拿了 31.39,GPT-6 Astra 是 28.97,而且每局成本大概只有gpt的 1/20。
3、真机测试:19 个真机任务上,也超过了微调过的 π0.5 和 zero-shot 的 Dream-1。
一句话:机器人上面那层物理AI"大脑",现在不一定非得靠闭源大模型+昂贵后训练了,harness 做好了,开源模型也能打。
#物理ai #robotagent

‼️ Can Qwen directly control the robot as well as GPT-6 Astra?
🚀 Introducing uni-robot-agent: a unified harness for Robot-Use Agents (RUAs), a first step toward RUA training and local deployment.
We tested uni-robot-agent with Qwen3.8-Flash-Next running locally:
1️⃣ On RoboDojo, its score rose from 1.90 to 31.39, surpassing the RoboDojo Team’s score with GPT-6 Astra.
2️⃣ On real-world tasks, it outscored fine-tuned π0.5 by 5.75 points and zero-shot Dream-1 by 10 points.
🧵 [1/7]


你想让AI自动筛选出美食网站上所有“健康食品”的照片,有时候AI搞不准,这是因为你也没把标准搞清晰
比如你告诉AI,找出所有健康食品
AI开始分类,边界清晰的容易判断,但有些东西未必有唯一正确答案,你也没说清楚所谓的“健康”究竟是指什么
于是你不得不一遍一遍改提示词
谷歌开源了一个AI分类框架:Agile Deliberation,让AI主动寻找那些难以判断的边界案例,反过来帮助人们把模糊的判断标准变成明确可执行的分类规则
简单说,就是AI的角色变了
过去你告诉AI什么是对的,现在AI帮你发现,你自己究竟认为什么是对的
等你的标准越来越清楚,AI再据此优化分类规则
整个流程有两个核心阶段:
Concept Scoping,界定概念范围
先把模糊概念拆开,明确应该包含哪些情况,排除哪些情况,建立初步分类规则
Concept Iteration,迭代分类标准
AI主动去找容易产生争议的边界图片,让用户判断是否符合当前分类标准
然后系统根据反馈不断调整分类指令,再去找新的边界案例,直到规则逐渐符合用户真正想表达的标准
这个框架有几个非常应景的场景
平台内容审核,比如说什么样的广告属于误导性宣传?让AI找出有争议的案例,审核人员判断,完善审核规则
另外一个,企业数据标注,比如什么样的商品照片算高质量,什么样的广告素材符合品牌风格,AI可以通过边界案例帮助建立更一致的判断标准
#AgileDeliberation #AI分类 #AI规则优化


OpenAI用一个未发布的cyber模型自动挖掘Linux内核漏洞,一轮实验找出了948个独立的本地提权漏洞
今年7月GPT-5.6 Sol找到了166 个,这个新Cyber模型配合自动化流水线找到了948个,数量是之前的5.7倍
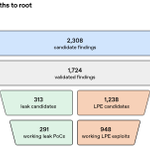
共发现了2308个候选问题,动态复现1724个漏洞
开发出1169个可工作的本地提权利用程序
去重后对应948个独立提权漏洞
整轮API成本约121万美元
说是团队抽样分析了166个利用程序,最少有10种是此前没见过的Linux漏洞利用技术
如果漏洞发现已经工业化,那下一步修复速度可能会变成新瓶颈
#AI找漏洞 #网络安全


Our security researchers built an autonomous cyber vulnerability discovery, exploitation, and patching pipeline.
In a single run with an upcoming cyber model, it validated and generated patches for 948 local privilege escalation vulnerabilities in the Linux kernel at a total API cost of $1.2 million.


腾讯刚刚发布了正式版:混元Hy4,增加了视觉理解和电脑操作能力,升级成了一个能看图、操作电脑、调用工具、执行复杂工作流的多模态Agent模型
现在能分析图片、图表,结合GUI和命令行操作软件,针对Blender、CAD等专进行了专项训练
同时强化了长程Agent、复杂办公、编程、金融分析和科研能力
目前已开放API,权重说是会开源
如果权重开了,对企业自有部署具有视觉理解、Computer Use、执行复杂任务的多模态Agent多了一个选择
#混元Hy4 #开源模型


👋Hy4 is here, new with vision.
Firmly among the leading open models.
More productive everywhere: finance, frontend, game, officework, research…
Built responsibly, with cyber/biosecurity in mind.
Try it out and let us know!
🔗:hy.tencent.ai/research/hy4?l…

英伟达开源的一个能理解企业数据的AI语义大脑:Auto Ontology,让AI真正理解数据的业务含义,从而给出可信可审计的回复
它解决几个问题,大模型会查表但不懂业务口径
比如说,“上季度华东收入多少”,数据库里没有一个叫“华东收入”的字段
模型需要知道收入是由哪些字段计算、华东对应哪些地区、时间字段应该用下单日发货日还是开票日、哪些表能连哪些不能连
Auto-Ontology就是先把这些定义整理出来,让模型按已认证口径查询
还一个,数据分析师在重复解释上浪费时间
“这个收入为什么不等于财务报表里的收入”、“这张表应该和哪张表连”等等
Auto-Ontology就可以把这些重复知识固化成可查询、可审核、可复用的语义层,减少每个AI、每个用户都重新猜一遍的情况
核心工作流包括这几步:
1、Discover自动发现数据结构
读取数据库元数据,识别业务实体、字段、关系以及潜在的语义关联
2、Ground语义落地
把“客户”“订单”“收入”等业务术语映射到具体表和列
3、Certify人工认证
业务人员可以检查、修正业务术语、SQL指标以及表关系,对经过核验的语义定义进行认证和管理
4、Validate校验查询
查询前先判断当前数据是否真的支持这个问题,比如计算广告回报率时,如果缺少广告支出数据,它会要求澄清,不是说硬算一个广告回报率
最大的价值应该是它把“企业数据是什么意思”从分析师脑子里的隐性经验,变成了AI可调用、可认证、可审计的基础设施
你的销售Agent、财务Agent、运营Agent也不必各自盲猜含义,可以基于统一的业务定义理解查询数据
#AutoOntology #企业数据AI #企业AI


当你调用某个大模型API时,怎么证明真正回答你的就是商家说的那个模型?怎么知道有没有被偷偷换成别的便宜模型?
Anthropic刚开源了FlashProve,一个基于零知识证明的大模型推理验证系统,让服务商为模型推理结果生成密码学证明,验证输出确实来自事先承诺的模型权重
以后AI服务商给你说用的哪个模型,你可以验证
而且,验证者不需要拿到模型权重,也不需要GPU,只用普通CPU就可以检查证明
Anthropic用Meta的Llama 4 Maverick做了实验,总参数约400B、每Token激活约17B的一个MoE
单张H100大约以110 token/秒生成证明;每1024 token请求的证明约19MB,普通CPU大约十几秒可以验证
成本仍然是高的,生成证明大约消耗正常推理72~94倍的 GPU时间
FlashProve的证明生成器、验证器和相关形式化证明代码全部已开源
#FlashProve #可验证模型 #可信AI


New Anthropic research: progress on provable inference for large language models.
Here, we introduce FlashProve. Building on established cryptographic techniques, FlashProve allows developers to verify whether a given response came from a given AI model. It’s substantially more efficient than prior open-source methods for doing so.
These proofs have a range of applications. They can, for instance, make it harder for attackers to hijack a chat, or enable safety evaluators to verify that the model they’re testing is the same one being served to customers.
For our full write-up, see here: anthropic.com/research/prova…
Further progress in provable inference will likely be an important part of improving trust in AI deployment. To that end, we're open-sourcing FlashProve’s code, here: github.com/anthropics/FlashP…
We’re grateful to our collaborators: Alessandro Chiesa, @GiacomoFenzi, @gwberg95, @miranda__christ, Rahul Dalal (rdalal.github.io) and Ben Mayer (@transmissions11).


Jev的同类选手,Levanto Labs搞的:Sage2,除了决策,还外加了信息提取和流式上下文处理
称Extract成本比Opus 5.5低166倍,持续增长的上下文场景中决策速度快3倍,超Cloudflare的Clairic
Sage2有两个核心能力
Extract:自然语言直接变成结构化数据
比如你说“帮我查昨天买的两张机票”,模型可以直接提取时间、数量、商品、查询意图等字段
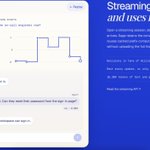
Decide:支持Streaming实时语义决策
也就是说它支持让上下文持续输入,模型边接收新信息边更新判断,无需每次都重新提交完整历史
比如你先说想退款,接着又说商品没问题,最后只是想换个尺码
Sage2则可以随着对话推进不断更新当前判断
这个就比较适合实时客服、Agent动态路由的场景
#Sage2 #AI决策模型 #实时语义决策


Software can now understand human language and act on it, in real time.
Introducing Sage2
- Extract: natural language in, structured data out. 166x cheaper than Opus 5.5, beats @Cloudflare's Clairic
- Decide: the first decision model with streaming. 3x faster, because it reads the context as it grows.
Sage2 is a new primitive for developers. Get 20M tokens free 👇
Also available on @near_ai and, for agents, via @mpp with @Stripe cards and @Tempo stables.

DeepSeek越来越有意思了,你DeepSeek Harness上缺什么插件,换Creator Mode模式,直接用自然语言让AI在Harness上现给你攒
不愧DeepSeek,果然一切皆插件。工具、Skill、界面等都可以通过插件机制扩展,AI生成的新功能直接变成了现有系统的一部分
如果这事儿可行,那等于重写了一部分软件分发方式,轻量小工具啥的直接被挤掉
比如说海报页、看板、阅读器、简单剪辑、内部报表这类够用就行的低代码/微型SaaS小工具,直接就被这个插件玩儿法分流走了
另外官方把7套插件玩儿法都甩出了,直接复制提示词,复制进Harness,勾选Creator Mode,可以试着复现(单条prompt一次生成可能不完全一模一样)
#DeepSeekHarness #CreatorMode #插件即功能
MIT CSAIL研究人员让GPT-6 Astra去修改Qwen3.5-0.8B的权重,只改动了0.016%的参数,就让数学测试成绩提高了6倍
不走梯度下降、不做训练,只动了约0.016%的权重,在最强示例里,MATH-500从7.9%提到 48.1%
过去优化模型,通常需要收集数据、训练、调参,消耗大量计算资源
这个有点像给神经网络做基因编辑,让更强的模型分析小模型内部参数,找到与重复推理相关的权重方向,再针对性的修改少量参数,缓解推理死循环
作者把这叫Weight-Space Programming权重空间编辑
如果可复现,这可能会改变AI行业优化模型的方式,甚至催生出一种新分工,让大模型充当小模型的工程师
#AI优化AI #AI模型优化 #AI自我改进


We asked GPT-6 Astra to edit Qwen3.5-0.8B weights to improve math.
It directly changed only 0.016% of weights, fixing 0.8B's reasoning loops & improving math up to 6x and even instruction following 3x, without gradients or training.
We call this Weight-Space Programming: frontier LLMs can now natively read/write neural network weights! 🧵
Blog: rikiyat.github.io/blog/weigh…

Readers added context they thought people might want to know
LLM was given weights explicitly as text in prompt and used code/forward passes (per authors' logs) to ablate Qwen looping direction, a known thinking-mode issue per model card. Primarily fixed repetition in that mode, not general 'natively' improving weights/math.
rikiyat.github.io/blog/weight-sp…
github.com/RikiyaT/lm_und…
huggingface.co/Qwen/Qwen3.5-0…
huggingface.co/RikiyaT/Qwen3.…
