

half hardware, half AI explainers and tutorials tech sales/gtm
Joined July 2024
- Tweets7.5K
- Following496
- Followers1.5K
- Likes7.8K




分享一个收藏许久的 Agentic RAG 案例:⬇️
把大模型 grep/ls/find/cat 的 shell 工具调用,翻译成轻量的向量数据库操作
需求:大模型引用外部知识库准确回答用户问题
基础 RAG:把外部知识库切分成 chunk,转换为词嵌入 存储在向量数据库(例如 chroma)里面;再把用户的问题转换成词向量,再从向量数据库里面匹配出最相关的文本 chunk;这些 chunk 再喂给 LLM 作为回答参考
mintlify 的改良动机:Agentic 查找越来越流行,如果大模型可以调用 shell/bash 工具,运行 grep/ls/find/cat 等命令,在思考-调用-观察的循环里查找相关文档作为回答参考,准确率会比基础 RAG高得多
改良阻碍:如果文档库和 Agent 都运行在云端(而非本地),服务端需要给每次查询创建一个 Sandbox/micro vm 来提供 agentic search 所需的 shell,grep/ls/find 程序和 file system,然而创建沙盒的时间和金钱开销完全不值得知识库问答这样的简单即时任务
改进思路:用 just-bash 这个项目(运行在内存里的模拟 shell,自带 grep/ls 等基础命令的解析),并且重写里面三种命令的实现方式:
读取文件内容(cat)、字符串搜索(grep)、文件树查找(ls, find)


对于治理者来说这种技术平权有点恐怖)
未来 LLM 的概率肯定不为零
Buy more compute...

mygo + mihomo / sing-box
token 溢出,用 @localhost_4173 低空老师的 mygo 搓了个科学应用,几句话就搞完了,得益于 go 生态的完善,客户端和网络底层无缝衔接
以后是个应用自由的时代了


发现了个安装和使用 DBSkill 的方便办法:
Codex 的云端环境
毕竟这一套几十个 skill 太重了,我还是得单开一个项目来用,因为它不是针对某一类项目的 skill,是通用性的 skill


公司推 AI 培训后,感觉没讲到位的东西
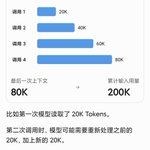
WorkBuddy/其他 agent 的 会话里面不要切换模型:因为一个会话(也是一个上下文)是有前缀缓存的,中途切换模型会导致缓存失效,就算切换了更便宜的模型,重新建立缓存也是非常昂贵的;
且不说每个模型在执行 agentic 任务时的 token 概率分布,是它在训练中独特习得的,突然把当前 token 序列给另一个模型,新模型怎么可能表现好呢
对话选择什么模型?既然你都用 “Work”buddy 了,加上不太富裕的积分,无脑选择 Deepseek V4.1 Flash:市面上所有的前沿模型在训练里,更多的是为 Agentic Coding 来训练的,没有任何一款模型还是为所谓的 Work 来针对训练的(Workbuddy 之所以从 Codebuddy 独立出来也是因为 Coding 模型的能力外溢),没有哪个模型比另一个模型更会操作 PPT、 PDF;这些办公 skills 已经烂大街了,直接接上给 Deepseek v4.1 Flash 就足以了
比 Deepseek 更便宜的免费模型,或者是其他 Flash 模型,表现肯定不会比 Deepseek 还好
如果你做 Coding 任务,就不在讨论范围了,使用世界上最强的模型,毫无疑问
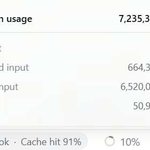
river ai 的 deepseek flash 价格和 caching都挺不错的,下午部署一个本地 ASR,一个多小时花了 13.2m token,花了 0.115 刀,相比DeepSeek 官方低谷价 0.14 刀确实低一点
当然最优惠的就是前两天注册送了 25 刀!


有 DeepSeek Flash 需求的朋友可以来注册这个新的 Inference Provider 试试,真的有 25 刀的注册额度!


We’ve launched fast production inference for open-weight models! Anyone who signs up right now gets $25 in free credits to spend on the platform.
DeepSeek v4.1 Flash and GLM-5.3 Flash are 20% cheaper than the offerings from DeepSeek and ZAI.
At River AI we’ve written our own training and inference stack from scratch in Rust, which unlocked much higher efficiency. We’re passing the savings on to our customers. Enjoy!

