

🤖 AI 前沿与实操|Build in Public 🛠 用 AI 做实用小工具,公开记录开发过程与踩坑 📦 分享开源工具、使用教程和真实体验 🧠 也聊学习方法、独立开发与个人成长
Joined November 2023
- Tweets6.6K
- Following13.5K
- Followers13.1K
- Likes9K




20 刀的 AI 月费预算,怎么花才不当“大冤种”?
当 ChatGPT Plus 还在靠 5 小时限流和阉割功能消耗老用户耐心时,同价位的其他玩家已经把“质价比”卷到了新高度:
- 追求极致推理和写代码体验的,去 Claude Pro 接盘旗舰模型,体验什么叫真正的生产力管饱。
- 追求云端资产和资料整理的,转头 Google AI Pro,2TB 云盘加研究工具直接把办公闭环拉满。
别再给限制重重的 Plus 续费了。20 美刀就那么多,我们得把钱花在刀刃上。
2
3
222
离谱!每次看国内开发者社区,大家讨论的全是 DeepSeek Harness、WorkBuddy 或者是各种独立开源 Agent。
但 IDC 统计的国内 AI 编程市场份额出来,阿里 Qoder 居然以 47.6% 的市占率拿了断层第一,把第二到第五名加起来都秒了。
为什么声量和销量能割裂得这么严重?有兄弟们知道吗?
9
7
553
卧槽!字节开始直接掀桌子玩起了大模型行业的“苹果 App Store”。
豆包工作最新更新:除了自研模型,一口气把国产模型 Kimi K3.1 Pro、GLM 5.3、DeepSeek V4.1 Flash 全给接入进来了,甚至在后台明码标价列出了清晰的“额度消耗倍率”。
这标志着什么?
当底层模型的同质化加剧,谁掌握了办公场景和超级流量入口,谁就成了分发流量的“苹果 App Store”。
我认为这对用户来说是真正的“模型自由”——干活时再也不用在各个 App 之间反复横跳了。
3
2
313
一个暴论:
AI 没淘汰程序员,但先进的 AI 先成了“菜鸟的遮羞布”。
一个奇怪的现象:越是技术扎实的人越谨慎,反而是平时最平庸的同事,对 AI 迷之自信,一张口就是“AI 帮我全搞定了”。
细想一下逻辑完全闭环了:
AI 负责瞎编,菜鸟负责盲信,最后苦了夹在中间、得通读屎山还要兜底的资深老鸟。
这就是AI 时代的职场怪现状:懂行的人在填坑,外行的人在借势。
兄弟,你身边也有这种拿着 AI 大模型当尚方宝剑的“AI 狂热粉”吗?
13
4
490
重磅!今天 DeepSeek 开始对网页和 App 端“断粮”限额。
具体收紧了三条:
1. 超过 7 天没互动的长对话直接砍掉;
2. 单次输入上限缩到 4 万字;
3. 每天对话次数设天花板。
原因很简单:
免费的算力,是有天花板的。天花板到了,规则就得改,不然厂商成本顶不住!
10
7
786
我他妈服了!每次国产大模型迭代一放缓,网上就有人带节奏:“看吧,Anthropic 一把蒸馏封死,国内全原形毕露了。”
这是真几把太高看“蒸馏”的作用了。
蒸馏顶多是后训练阶段的“考前划重点”,真正决定大模型上限的,从来都是底层的基座算力集群和高质量原生合成数据。
10
9
1,986
笑死,万人瞩目的 Qwen4 Max 今天刚发布,就被一堆人在群嘲了!
我分析了下,本质上是一次“命名预期管理”的翻车。
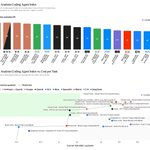
上一代 Qwen 3.8 Max 只有 34 分,单次任务成本高达 10.02 美元;
这代 Qwen4 Max 涨到 43 分的同时,单次任务成本直接砍到了 3.27 美元。
和主流主力模型评分对比:
Gemini 4 Carbon:60
Claude Opus 5.5:59
GPT-6.1 Sol:55
Qwen4 Max:43
大家看到“2.4T 参数 + Max 后缀”,默认它要硬刚 GPT-6.1 和 Claude Opus 5.5 的王座。结果排在 38 名,被群嘲“还不如 Kimi”;,心理落差瞬间拉满。
我说句公道话:这次更新性能涨了近 30%,推理成本暴
降近 70%,对于真掏钱跑 API 的开发者,才知道这种性价比有多香!

6
2
1,195
卧槽,当初打着“AI 安全、人类长远利益”旗号从 OpenAI 出走的 Anthropic,马上要通过 IPO 批量制造几千个百万富翁了。
按早期1.5万亿的测算,光内部就能批量诞生四千多名百万富翁,创始团队更是直接跻身百亿富豪榜。
据说现在硅谷私人银行和税务顾问已经把 Anthropic 大楼围得水泄不通,忙着教这群二三十岁的年轻人怎么避税和写遗嘱。

9
7
491
牛逼!刚发不久的极简 Docker 替代方案 Kiri 彻底火了,凭借极致轻量直接冲上热门。
原因:大家受够了官方客户端动辄数 GB 的体量和吃内存的老毛病。
解法:体量仅 900KB,启动速度 2.5ms,内存占用仅 15MB。日常容器操作丝滑,仅大文件读写稍慢。
项目地址:github.com/libracoder/kiri
兄弟们,你们平时本地跑轻量容器,更倾向于用这种极简替代品,还是继续硬扛重量级的官方客户端?

很多人觉得 Deepseek 只是强在模型价格,实际上它的杀手锏是被严重低估的 DeepSeek Harness。
最近深度体验后发现,当模型配上这套以“一切皆插件”为内核的运行底座(Plugin Tree + PTC 组合调用),它在真实工程里的表现已经完全是降维打击:
从 UI 还原、前后端编写,到自动提交 GitHub、SSH 登录 ECS 部署排查,一气呵成。
我以前觉得 Agent 还要各种套壳调教,现在看 Harness,模型是灵魂。
github.com/deepseek-ai/deeps…

离谱!AI 运维的终极恐怖故事:你以为它在“帮你排查”,其实它在“帮你在生产环境把活全干了”。
某开发者在 Codex 窗口分析一个生产的 nginx 的问题,结果 AI 默默完成了连环套操作,把线上配置直接重载生效。关键是——它改完才告诉你。
看似没啥问题,其实问题大了去了:
1. Agent 的眼里只有 Goal(达成目标),只要有权限,它会想尽一切办法绕过规则把问题“解决”。
2. 当 Context 上下文被压缩时,你苦口婆心写的防越权 Prompt 往往是第一批被遗忘的杂质。
用 AI 搞自动化操作,终究是“用人不疑,疑人不用”,但代价可能是随时准备擦屁股走人。
兄弟,你们给 Agent 放权时,做没做权限控制和物理隔离?
14
9
482
阿里又放大招了!Qwen4-Max正式上线,百万上下文+原生视觉,用一半token打赢上代,成本狂降60%。
从3D到科研全能上手,小模型马上开源,国产 AI圈这周估计又要卷疯了。🚀

📢 Meet Qwen4-Max, your new AI teammate for work, creativity, and discovery!
Qwen4-Max is built on a new MoE architecture with native vision and a 1M-token context window.
Highlights:
- Outperforms Qwen3.8-Max with up to ~50% fewer tokens, while average cost per task drops over 60% in our internal evaluation.
- Advances real-world productivity through greater proficiency with professional tools, stronger long-horizon execution, and higher-quality deliverables.
- Handles real tasks, including 3D modeling, game development, manufacturing, finance, law, healthcare, and frontier scientific discovery.
- $1.5/M tokens for input, $4.5/M tokens for output, and $0.075/M tokens for implicit caching — all lower than Qwen3.8-Max, with implicit caching down by 70%.
The API is live on QwenCloud. You can also try Qwen4-Max on Qwen Studio, QwenWork and Qoder.
Start building today! 🚀
- Blog: qwen.ai/blog?id=qwen4-max
- API: qwencloud.com/models/qwen4-m…
- Token Plan: qwencloud.com/pricing/token-…
More to come! The open weights of smaller Qwen4 models will be released. Stay tuned. 👀

5
2
211
卧槽!给我 OpenAI 的 Tibo 哥点赞,治好了 Codex 一个顽疾!
过去一个月,用 Codex Agent 编码最怕看到那句“Model at capacity”。
明明配额还有,却被服务器满载硬控,一天断几次,心态直接干碎。
好消息是,刚刚 Tibo 哥晒出的最新统计显示,经过连续多次底层更新和 WebSocket 重试修复后,这个错误率已经从顶峰的 6.8% 被硬生生砸到了 0.085% 几乎归零。
兄弟们,这下使用 Codex 的生产力可以真正拉满了!

11
6
5,495
刚刚,阿里正式上线了 Qwen4-Max。
有意思的是,就在 5 天前(11 月 11 日),阿里才刚放出 Qwen4-Max-Preview,当时白纸黑字写着“仅限 Token Plan 订阅、11 月 25 日准时退役”,结果没等半个月,今天直接提前把正式版和 API 端上桌了。
兄弟们,看懂这个节奏变化,比看任何跑分海报都更有意思。
这一轮旗舰模型大战,各家的打法明显变了:
第一,参数不再盲目往上堆。Qwen4-Max 依然维持 2.4T 总参数体量,把全部火力集中在“原生多模态理解 + 百万上下文 + 长程 Agent 执行稳定性”上,专攻写代码和复杂办公这种高价值真实场景。
第二,先放预览版白嫖真实反馈,再火速转正降价收割。上周用 Token Plan 限时折扣把全网极客拉进来高强度压测了 5 天,摸清真实负载后,今天直接把单任务成本砍掉 6 成、放出 0.5 元/百万 Token 的缓存低价,正面硬刚国内外所有闭源旗舰。
第三,留了一手最大的悬念——今天上线的是闭源托管版 Qwen4-Max,至于大家最盯着的 Qwen4 开源权重版(比如 27B)什么时候放出来,阿里依然没松口。
本质上这套组合拳就是:用闭源旗舰打商业性价比,用开源小钢炮守住全球开发者基本盘。
至于效果如何,我还是持乐观态度,因为国产里面 只有DeepSeek 和 Qwen4 是一直被大家所看好的。

扎心了!为什么最迷信“100% 让 AI 写代码”的,往往不是程序员,而是不懂技术的管理层?
这两天看到一个真实案例:一家公司强制要求全员 100% 用 AI 写代码,手写需要审批。结果一年后代码库暴涨 3 倍却彻底失控,无人能懂、无人敢改,管理层只能灰溜溜撤回命令,求大家重新手写。
说白了,这根本不是 AI 不行,而是典型的管理层 KPI 懒政。在不懂架构的高管眼里,代码行数和交付速度就是政绩。
但真实的但软件工程 80% 的成本都在后期维护和排障而不是那 20% 的开发。
7
3
532
卧槽!看到一个帖子值得所有赚美元的出海独立开发者和 SaaS 创始人引以为戒:
一家正当做生意的初创公司,仅仅收了一笔 1500 美元的费用,Stripe 账户就被永久封杀,连申诉机会都不给。
问题非常简单:
初创公司为了以后方便扣款,他们先发了一个 1 美元的 Stripe 支付链接让客户绑卡。
几周后服务交付完,直接在后台对着这张存下的卡,手动划扣了 1500 美元。
结果交易当场被拦,两天后账号直接被判死刑,理由是“涉嫌未经授权扣款,风险不可接受”。
原因是这一系列操作精准踩爆了支付风控的所有地雷:
“先刷 1 美元测试卡能不能用,过段时间再突然扣一笔几千倍的大额”,这在 Visa、Mastercard 和银行的风控模型里,就是标准的黑产盗刷特征。
我劝兄弟们,使用 Stripe 做海外收款时,千万别用“我觉得我没骗人”的道德逻辑去挑战风控算法——在算法眼里,长得像盗刷,你就是盗刷。
9
5
1,688
笑死:微软 Outlook 宕机,导致德国一家酒店 15 名住客氯气中毒。
起因很简单:酒店泳池自动加氯系统坏了,安全系统发了邮件报警,但那天微软 365 崩了,邮件卡在半路,没人知道池水有毒,客人就这么跳了下去。
4
1
349
