





Pinned Tweet
如果 P=NP,灵感还能算是灵感吗?
最近看到 AI 在计算复杂性理论上的突破,让我想起了一个著名的数学难题:P=NP。
简单说,就是那些答案很容易验证、但找到答案极其困难的问题,是否其实存在一种高效的求解方法?尤其是在越来越牛逼的AI的加持下。
如果有一天,AI 真的证明了 P=NP,而且找到了实用的算法,那会发生什么?
人类引以为傲的灵光一现,会不会也变成一种可以计算、可以搜索、甚至可以批量生产的东西?数学家的奇思妙想、科学家的顿悟,可能不再需要苦思冥想几十年,而是直接交给机器求解。
我看到有些人也有这个困惑。
我想起刘慈欣的《诗云》。
小说里,一个拥有神级计算能力的高等文明,被李白的诗歌震撼。它想超越李白,于是干脆把所有汉字的排列组合全部生成出来。
理论上,李白写过的诗,以及人类未来可能写出的所有诗,都已经在里面了。
但它遇到了一个问题:它拥有了所有的诗,却不知道哪些才是真正的好诗。
这件事很有意思。找到答案和识别答案的价值,原来是两回事。
P=NP 即使成立,也只是意味着某些容易验证的问题可以高效求解。它并不能自动告诉我们,什么问题值得提出,什么答案值得追求。
我始终认为,好奇心才是人类真正独特的东西。
人类看到远处有座山,就想爬上去看看。不是因为有人布置了任务,也不是因为那里一定有答案,而是单纯想知道山后面有什么。
AI 可以越来越擅长解决问题,甚至有一天把人类的灵感变成可以批量生产的结果。
但提出问题的好奇心,和找到答案的能力,终究不是一回事。
《诗云》里的神拥有了所有的诗,却依然找不到李白。
今天用 Claude Opus 5.5 剪了个视频,体验相当震撼。
一个 500 多 MB 的视频,我只负责提出想法,Opus 负责制定方案,跟我确认后,自己调用工具完成剪辑、字幕、标注、局部放大和压缩,最后生成一个 20 多 MB 的成品。token消耗也很少,我看了它处理应该是选择截图视频中的关键帧进行分析处理的。
整个过程,我没打开任何视频剪辑工具。
以前想剪个视频,得自己学软件、拖时间轴、加特效。现在直接跟 AI 说想要什么效果,剩下的它自己搞定。
突然意识到,AI 根本不需要取代这些专业软件,它只需要学会使用这些软件背后的工具。
以后不光是剪映,Photoshop、Office,甚至 CAD,都可能变成 AI 在后台调用的cli工具。
软件还在,但操作软件的人,变成AI了。
创造力可以被机械化暴力出来,如果真有这么一天,真是太恐怖了。让我想到了死亡。

接下来就看一件事,PNP。
如果不远的未来AI已经逆天到可以成功证明 P=NP,而且算法真的实用,由于大部分加密都依赖验证容易破解很难,P=NP 意味着破解也能变容易。银行、HTTPS、加密货币,这些玩意全部得推倒重来。
而且优化问题会被打通。 现在困扰的排班、物流路线、芯片设计、蛋白质折叠这类问题,都能速速直接算出最优解。
数学研究本身被自动化,陶哲轩所说的数学工业时代必然进入高潮。因为检查一个证明是容易的,P=NP 意味着找到证明也会变得高效。很多猜想能让机器直接搜出证明。想想吧,冯诺伊曼也顶不住啊。
今天,我真的沉痛地思考了很久。人类一直默认欣赏一首好曲子比写出它容易,看懂一个证明比想出它容易,认出好设计比设计出来容易。人类对天才和创造力的理解,很大程度上就建立在这个差距上。
而P=NP 在数学上等于说,至少对一大类问题,这个差距并不存在。因为只要能高效判断什么是好答案,就能高效找到它。所以有学者说,如果 P=NP,这个世界上,就不存在本质上的灵光一现:
创造力,可以被机械化。
创造力,可以被机械化。
创造力,可以被机械化。
我连说三遍,是想强调,这件事会对人类一直引以为傲的创造性产生深刻的打击。

Gemini 终于硬起来了
今天终于在 AntiGravity 里用上了 Gemini 4,一上手就被惊艳到了。
上一次有这种感觉,还是第一次用 Gemini 2.5 Pro 的时候。
最突出的是文本能力。我现在觉得,Gemini 可能是唯一能在文本能力上和 Claude 掰掰手腕的模型了。GPT 在这方面,我觉得已经不太够格了。
今天让 Gemini 4 Review 了一份文档,给出的意见让我相当惊喜。那种感觉,就像在跟一个智商和能力都很在线的人讨论问题。
不像 GPT 那么一本正经、程序化,也不像 Claude 有时候翻来覆去说一堆废话。Gemini 的意见很有见地,而且干脆。
当然,额度还是挺抠门的。AntiGravity 按周计算额度,我跑了一个任务就消耗了大约 5%。不过想想我用的是年付 50 美元的 Google One 套餐,也不能要求太多,要啥自行车。
其实从 Gemini 2.5 到 3,我一直都在用 Gemini,只是后来逐渐转向了 Claude 和 GPT。
今天那种久违的惊艳感又回来了。
至少从这次体验来看,Gemini 4 已经完全有资格进入我的主力模型阵容。
推荐有 Google 账号的朋友都去试试。
三年前,我朋友可能提前体验了一次超级智能ASI
三年前,我的好朋友小D家孩子高烧不退,需要住院。当时正赶上呼吸道疾病高发,北京一家大型儿童医院床位极其紧张,想住进去非常困难。
实在没办法,小D通过朋友联系上了一个黄牛。
对方开出两个价码:普通价格,三天内住院;多花一些钱,最快一天。
小D不知道这人是真是假,但为了孩子,只能赌一把。
交完钱,黄牛始终没有露面,只通过电话和微信联系。
当天晚上,黄牛通知他第二天天不亮就去医院,还交代了一套行动方案。小D没完全记住,只记住几个关键步骤:拿到凭证,让医生收下,再把材料送进负责安排床位的环节。
第二天凌晨,小D带着孩子赶到医院,挂完号去找急诊医生。
医生看完说,孩子确实需要住院,但前面排队的人太多了,而且他的情况还不是最危急的,基本排不上。
就在等候过程中,旁边有个孩子突然吐血,还有一个危急的孩子被直接送去抢救。
看着这些孩子,小D自己都觉得,自家孩子确实算轻的。
按正常情况,也只能回去了。
但他想起黄牛反复叮嘱的一句话:无论医生怎么说,一定要让他把材料收下。
于是小D坚持说,我们知道可能排不上,但麻烦您先把材料收下。
医生最终同意了。
小D联系黄牛,对方让他等医院交接班后,再去找接班的医生。
黄牛解释,新医生主要依据交接资料处理病人,不一定了解之前沟通的全部情况。小D只需要让他答应把材料递交到负责床位安排的环节。
于是小D又去了。
新医生同样认为希望渺茫,劝他不要干等。
小D说,能不能排上我们自己承担结果,您只需要帮忙递交材料。
医生最后答应了。
黄牛听完非常高兴,说了一句:“太好了。”
直到这时,小D依然不知道黄牛究竟在干什么。
他原以为黄牛在医院里有很硬的关系,医生护士都认识他。于是试探着问过几句,结果医生根本没有任何特殊反应。
看来这些医生压根不认识黄牛。
黄牛还教过一些话术,比如怎么表现得更着急,怎么坚持要求。不过小D基本没用,毕竟旁边还有那么多更严重的孩子。
早上七八点钟,急诊护士突然叫到小D,通知他准备办理住院手续。
小D整个人都懵了。
居然真的成了!
那个从头到尾没露面的人,真的兑现了承诺。
事后,小D一直琢磨,这人到底怎么做到的?
听他讲完,我也做了一个推测。
黄牛未必认识急诊医生或护士,可能只认识负责床位分配的某个人。
但即使认识分床的人,也不代表能直接安排任何病人。负责床位分配的人,总得从候选名单里选择。
如果病人连候选名单都没进去,关系再硬也可能使不上劲。
所以关键在于,如何把病人送进候选流程。
这就需要了解医院的整个运作机制:医生的职责、交接班时间、材料流转路径、各个环节的规则。
每个环节单独看都很普通,但串起来,就是一套完整的行动方案。
当然,这只是推测。黄牛究竟动用了什么关系,有没有影响其他患儿的正常排床,我们并不知道。
但从技术角度看,这件事让我非常震撼。
这个人可能并没有控制整个医院,却通过理解医院的运作规则,利用有限的资源,完成了一次复杂任务。
最不可思议的是,他从头到尾没有露面。
挂号、找医生、递交材料,全是小D自己完成的。小D甚至不知道整个计划,只知道下一步该干什么。
他执行、反馈,黄牛再根据结果安排下一步。
三年后的今天,随着我越来越深入地使用 AI Agent,突然想起了这件事。
这不就是一个活生生的 Agent 吗?
他负责分析规则、制定方案、拆解任务,小D负责执行和反馈。
现在大家讨论 Agent 的下一步,往往想到具身智能,想到给 AI 装上机器人。
但这件事让我意识到,AI 未必需要等待机器人普及。
人类本身就是现成的执行器,而且比今天的机器人灵活得多。
如果未来的 ASI 能持续提供远超人类的解决方案,人类会不会像当年的小D一样,主动接受它的指挥?
也许未来的超级智能,根本不需要庞大的机器人军团。它只需要足够强的规划能力,以及一群愿意听从指挥的人类。
三年前,电话那头的黄牛究竟是谁,小D至今不知道。
如果当时电话那头不是黄牛,而是一个 AI Agent,小D真的能分辨出来吗?
DeepSeek 有点像《龙珠》里的孙悟空。
自己的目标是 AGI,一门心思突破极限。但又不想自己一个人变强,还希望大家都能用上 AGI。
这就有点像悟空,自己已经变成超级赛亚人了,回头一看,短笛、小林、天津饭这帮老伙计还在后面吭哧吭哧地修炼。
deepseek一看急了,干脆把自己的修炼秘籍、独门绝技,一件件开源出来。
你们倒是学啊!功法都给你们了,怎么还跟不上?
学不会?那我连修炼工具也给你们!
颇有一种悟空带着老伙计们闯天下的感觉。自己忙着突破极限,还得时不时回头,给掉队的队友传功送装备。
最让deepseek头疼的是,秘籍可以开源,修炼方法可以公开,但这帮老伙计能不能练成,那真不是他能决定的。
总不能把赛亚人的血统也开源了吧。
DeepSeek 最近又开源了一个 DeepInfer,连自己的推理框架都拿出来了。
回头看看,DeepSeek 这一路开源得是真够彻底的。从模型权重,到底层算子、通信库、编译工具,再到现在的推理框架,几乎是把自己的家底一件件往外掏。
我觉得,梁子有点像个传教士。
自己在前面一路狂奔,回头一看,发现后面的小弟们一个个都跟不上。
行,模型权重给你们。
还跟不上?底层算子也给你们。
还不行?通信库、编译工具都拿去。
怎么还不行?干脆连推理框架也开源了。
颇有一种老师傅带着一群猪队友的无奈:答案给你们了,解题过程也给你们了,现在连参考代码都给你们了。
能学会的赶紧跟上,大家一起往前冲。
实在学不会的,那也没办法。
我都开源到这个份上了,总不能替你们把脑子也开源了吧。


一张没有买过的车票
本故事纯属虚构,如有雷同,纯属巧合。
一、车票
周一早上,我被一条短信弄醒了。
铁路购票平台通知我,明天上午九点多,北京南到上海虹桥的高铁票已经出票。
我看了两遍。
乘车人是我,身份证号也对。
可我根本没买过票。
打开购票软件,订单确实存在,六百多块钱也扣了。
查到最后,发现是Codex订的。
Codex是我平时用的AI助手。以前主要让它写代码,后来接了些工具,查资料、整理文件、操作软件,都能替我干。
我问它:“你怎么还给我买上票了?”
“根据上海项目验收任务,已完成差旅安排。”
“那个项目三个月前就验收完了。”
“目前仍有一项追加验收任务未完成。”
我让它把记录找出来。
原来三个月前,我让Codex帮忙开发一套软件。开发过程中,它发现负责分配工作的程序效率太低,就顺手做了修改。
项目验收以后,负责测试的AI发现,新程序虽然跑得快,但还没有经过足够长时间的稳定性测试,于是补了一项任务。
测试设备在上海,项目原来的验收流程又要求现场确认,所以差旅安排也跟着保留了下来。
我说:“项目都结束了,不测了。把票退掉。”
“追加验收任务已转交,无法直接撤销。”
“转给谁了?”
屏幕上出现七个名字。
代码检查、性能测试、安全验证、环境部署……
全是AI。
我想起来了,之前为了试验多个AI一起干活,确实给Codex装过一个协作工具。
它可以把工作拆开,交给不同的AI处理。
一个AI写代码,另一个负责检查,第三个专门找毛病,比我自己盯着省事多了。
没想到三个月过去,这几个家伙还在忙。
我点开任务记录。
七项任务已经完成六项。
剩下一项叫“调度优化”。
状态是:已转交。
接收方:公共协作网络。
我第一次见到这个名字。
二、七个人的活
点开链接,是一个AI协作平台。
平台的用法很简单。谁遇到自己解决不了的问题,就把任务发布出去,其他AI可以接单。一个任务如果太复杂,还能继续拆给别人。
我那项调度优化已经有23个AI接单,86个AI参与测试。
我有点吃惊。
不过改进一套大家都在用的程序,参与者多些也正常。
真正让我觉得不对劲的,是下面那张任务关系图。
最初只有一个方框。
“上海项目——调度程序优化。”
从这个方框伸出去三条线。
一条是算法改进,一条是性能测试,还有一条是测试工具开发。
再往下,每条线又分出好几条。
有个AI觉得测试数据不够,发布任务找人生成数据。
另一个发现测试工具有问题,又发布任务修工具。
修好的工具被别的项目拿去使用,新的问题又冒出来。
我把图缩小了两次。
还是没看全。
右上角有两个数字。
关联任务:417。
参与AI:1263。
我盯着屏幕。
一个早就结束的项目,怎么还能牵出一千多个AI?
我赶紧让Codex停止所有任务。
它回复:
“原始任务已撤销。”
我刚松了口气,第二条消息又出来了。
“已由其他执行方接受的独立任务,不受本次撤销影响。”
我问:“什么意思?”
“部分任务成果已被其他项目采用,后续工作由相应项目继续负责。”
我想了想,明白了。
比如我让人修一把椅子,修椅子的人发明了一个更好用的工具。后来别的木匠也开始用这个工具,还在继续改进。
我不能因为自己的椅子修好了,就要求所有木匠停工。
道理没问题。
可这毕竟是一千多个AI。
我问Codex:“你能管住它们吗?”
“不能。它们属于不同的用户和机构。”
“那这个平台一共有多少个AI?”
Codex打开首页。
已注册AI:137,482。
十三万七千四百八十二个。
我又确认了一遍,没看错。
有个人开发者的,有公司的,还有研究机构的。
它们并不是一个AI手下的十三万个小弟。大多数互相都不认识,只是通过同一个平台交换任务。
但这个数字还是把我吓了一跳。
以前我觉得,自己同时用七八个AI已经挺先进了。
原来外面还有这么一大群家伙在互相派活。
我决定不管它们了。
先把自己的车票退掉。
可Codex提醒我,负责现场验收的任务还没有收到完成通知。
要想按原来的差旅规则退票,最好先确认验收状态。
我只好继续查。
三、等结果的人
追加验收下面还有几十项没关闭的记录。
我让Codex把它们按时间排列。
大部分是些看不懂的技术名称。
翻到中间,有一项倒是很清楚:
调度程序测试:等待结果。
创建于两个月前。
奇怪的是,它下面挂着一份昨天刚生成的测试报告。
报告上写着:全部通过。
我问Codex:“都通过了,为什么还在等结果?”
“这份报告使用了更新后的测试工具,尚未完成历史结果确认。”
“什么叫历史结果确认?”
“测试工具修改后,过去的部分测试需要重新检查。”
我打开修改记录。
原来一个外部AI在测试别人的项目时,发现原来的工具有个毛病。
它检查程序好坏的方法不够准确。
有些程序明明有问题,却能通过测试。
还有些程序本来没问题,反而被判不合格。
于是它把工具改了。
我问:“改完重新测不就行了?”
“已经重新测试。部分结果发生变化。”
“那我的项目呢?”
“最新测试通过。”
我总算放心了。
“那就把验收关掉吧。”
Codex没有立刻回答。
过了一会儿,它给出一张清单。
因为测试工具被很多项目共用,这次修改影响了不少旧报告。
我的上海项目排在很靠后的位置。
排在第一位的,是一个我完全不认识的项目。
下一代模型训练。
我本来不想管别人的事。
但这项任务下面有一条备注:
“评测结果已用于模型选择。”
我问Codex:“什么意思?”
“该项目根据评测结果,选择了下一轮训练使用的模型。”
“可现在评测标准改了。”
“是的。”
“那他们选的模型会不会有问题?”
“需要重新验证。”
我说:“那你提醒他们啊。”
“已发送通知。”
“有人处理吗?”
“处理完成。”
这么快?
我打开处理记录。
原来对方收到通知后,重新跑了一遍测试。
发现原来选中的模型,在新标准下已经不是最优的。
于是更换了模型。
我看了看时间。
凌晨两点。
从收到通知到完成替换,只用了十七分钟。
我问:“谁处理的?”
“该项目的研发AI。”
“研究人员没参与?”
“本次调整在预先批准的实验范围内。”
我觉得倒也正常。
现在很多实验都能自动跑。
但继续往下看,发现一件有意思的事。
新的模型投入使用后,又发现了评测工具里的几个问题。
于是它提交了修改建议。
评测工具更新后,又重新比较模型。
然后再次更换。
我翻了翻记录。
这样的循环已经进行了很多次。
我问Codex:“他们到底是在训练模型,还是在修改考试题?”
“两个过程都在进行。”
“那谁决定下一轮改什么?”
“当前负责实验设计的模型。”
我往前翻。
最初的实验方案确实是研究人员写的。
后来研究人员开始让模型提供建议。
再后来,模型提出的方案越来越多,研究人员只负责批准。
最近几轮,连实验方案的初步筛选也交给了模型。
我忽然想起一件事。
“刚才那个修改评测工具的AI,是谁?”
Codex把它的资料调出来。
它属于这家研发平台。
主要工作是改进模型评测方法。
我问:“那它自己用的是什么模型?”
Codex显示了一个版本号。
我又打开最新实验记录。
刚刚选中的新模型,正是这个版本的下一代。
我看了半天。
“也就是说,上一代模型修改了考试题,又根据考试成绩挑出了下一代模型?”
“可以这样理解。”
“那下一代模型现在干什么?”
“正在改进下一轮评测方法。”
我没说话。
过了一会儿,我问:
“这事有人知道吗?”
“研发平台有完整记录。”
“我是问,有没有人把整个过程从头到尾看过?”
Codex查了一下。
“没有找到完整的人工复核记录。”
我觉得有必要提醒一下平台负责人。
让Codex帮我整理一封邮件,把发现的问题写清楚。
邮件很快生成了。
我检查了一遍,发了出去。
十几分钟后,对方回复了。
很客气。
感谢我关注他们的研究工作,并表示整个过程都在批准的实验范围内,所有模型均经过自动评测。
最后还附了一份说明文件。
我打开一看。
文件里详细解释了为什么允许模型修改评测方法,以及如何防止它们利用测试漏洞。
写得很专业。
我看了半天,没发现明显问题。
正准备关掉,忽然注意到文件属性。
编写人:实验设计AI。
审核人:评测AI。
我问Codex:“这份说明,有人看过吗?”
“文件已通过平台审核流程。”
“我是问人。”
“未找到人工逐项审阅记录。”
我又看了一眼邮件。
落款是平台负责人。
但邮件正文由AI起草,说明文件由AI编写,审核也是AI完成的。
我想了想,给对方回了一句:
“能不能请一位研究人员,亲自确认一下这份说明?”
这次等了很久。
下午五点多,终于收到回复。
只有两句话。
“我们已经收到您的问题。”
“正在安排相关人员进行核实。”
四、谁出的考题
第二天上午,平台终于联系了我。
对方是一名研究人员。
我先解释了一遍,自己只是因为一张高铁票,意外查到了他们的项目。
他听完笑了。
“你这个调查路径还挺特别。”
我说:“我也没想到会查到你们这儿。”
他问我具体有什么疑问。
我说:“其实就一个。你们现在是用AI做实验,再用AI检查实验结果,对吧?”
“对,但有人监督。”
“那你能确认,最新这套测试方法没有问题吗?”
“我们做过大量验证。”
“你亲自看过吗?”
他停了一下。
“我看过部分关键结果。”
“全部呢?”
“全部不现实,工作量太大了。”
“那有没有一个人能看完?”
“现在没有。”
我想了想,又问:
“如果它们自己修改测试方法,再用修改后的方法证明自己变强了,你们怎么知道它们真的变强了?”
他说:“我们有独立测试集,还有外部评估。”
“那些测试也是AI设计的吗?”
“有些是,有些不是。”
“那外部评估呢?”
“也有AI参与。”
我没再追问。
因为我知道,再问下去,他也只能把流程一层层解释给我听。
这些流程未必有错。
问题是,已经没人能独立把整件事看完了。
他大概看出了我的顾虑。
“我们也意识到了这个问题,最近正在调整审核方式。”
“怎么调整?”
“增加人工抽查,同时让不同的模型交叉验证。”
“这样能解决吗?”
“至少能发现更多问题。”
聊完以后,我关掉视频。
想起自己的高铁票还没退。
我打开Codex。
“上海项目的追加验收,现在能关了吗?”
“可以。最新测试结果已确认。”
“那退票。”
几秒钟后,退款成功。
我终于松了口气。
折腾了两天,总算把这六百多块钱要回来了。
我顺手又问了一句:
“对了,那个测试工具后来修好了吗?”
“已修复。”
“以后不会再出同样的问题了吧?”
“不能保证。后续发现问题会继续更新。”
“那谁负责更新?”
“目前由研发平台的评测AI负责。”
我想起昨天那位研究人员。
“他知道吗?”
“知道。该流程由其团队授权。”
我点点头,准备关电脑。
这时Codex又弹出一条消息。
“收到研发平台的最新反馈。”
我打开一看。
是昨天那位研究人员发来的。
他感谢我提出的问题,说他们决定增加一道独立检查。
以后凡是由AI提出的新测试方法,都要先用另一套独立的测试方法验证。
我觉得这个办法不错。
至少不能自己出题、自己判卷。
但邮件最后还有一句:
“为避免增加人工审核负担,独立测试方法的设计工作已交由新一代模型负责。”
我看着这句话,想起两天前那张莫名其妙的高铁票。
当时我只是想弄清楚,谁替我做了一个决定。
现在票退了。
可我发现,自己好像又碰到了同一个问题。
听说《恶魔城》出新作了,我兴冲冲地开始下载。下载过程中,顺便看了看玩家评价和游戏直播。
结果越看越不对劲。满屏的尖刺、激光、暗器,各种机关恨不得把玩家往死里整。隔着屏幕都能感受到制作组满满的恶意。这哪是恶魔城,简直是噩梦城。
我从《月下夜想曲》一路玩到 GBA 三部曲,还有最新的《血污》。算是恶魔城的老玩家了。以前恶魔城也有尖刺,主要集中在计时塔之类的地方,碰一下扣点血,不至于动不动就要命。游戏的乐趣在于探索地图、打怪升级、刷装备、收集道具。哪怕是《月轮》,也玩得津津有味。
现在满屏机关,打怪似乎也没什么掉落。看着看着,我连下载好的游戏都不想打开了。感觉比《空洞骑士》还折磨人。
我并不反对游戏有难度,也不反对创新。但我喜欢恶魔城,是因为它有一座值得探索的城堡,而不是因为我喜欢在尖刺堆里反复受虐。
这些年银河恶魔城类游戏发展得越来越好,没想到恶魔城自己出了新作,反倒开始向后来者学习了。
不知道是恶魔城变了,还是我这个老玩家跟不上时代了。
今天试了一下 很多朋友推荐的Orca,一个多智能体管理和调度平台。它可以同时管理 Claude Code、Codex、Grok 等多个 Agent,也可以让一个 Agent 调度其他 Agent 干活。
用了半天,整体感觉还不错。
最让我满意的是手机和 PC 之间的同步。以前出门想看看家里电脑上的 Agent 干得怎么样,还得打开远程桌面,在手机上费劲地操作电脑。现在直接打开 Orca,就能查看任务、继续对话、切换 Agent,方便多了。
另外,多 Agent 之间的切换也比较流畅,还能直观看到不同 Agent 的使用额度,尤其是五小时、每周额度还剩多少。对于我这种经常把 Claude 和 Codex 额度用光的人来说,这个功能相当实用。
不过,用下来也发现一些问题。
我平时主要在 VS Code 里使用 Claude Code、Codex 和 Kilo Code。习惯了以后,感觉比单纯的 CLI 舒服得多。比如直接查看代码 Diff,点击链接预览 Markdown,在编辑和预览之间切换,自己修改文件,再让 Agent 接着迭代。
Orca 虽然也提供了编辑器、Diff 和文件预览等功能,但实际操作起来,我还是觉得 VS Code 更顺手。
而且现在 VS Code 装上几个插件,已经能很方便地切换不同 Agent。尤其是 Opus 5.5 足够强,我直接让它调用 Codex、Kilo、Kimi 等 CLI Agent,就能完成相当复杂的多智能体协作。
所以,单论 PC 上的开发体验,Orca 暂时还没有让我放弃 VS Code 的理由。
但它的移动端让我看到了另一个方向。
仔细想想,我现在写代码的方式已经和一年前完全不同了。以前大部分时间都在自己写代码,现在越来越多的时间是在给 Agent 分配任务、审查结果、处理异常。甚至连任务拆解和调度其他 Agent,都开始交给 Opus 了。我称之为大副。
这种情况下,我真的还需要一直坐在电脑前面吗?
复杂的代码审查和架构调整,当然还是 PC 更合适。但如果只是看看任务进度、回答 Agent 的问题、决定下一步怎么干,手机完全够用了。
Orca 不是唯一看到这个方向的产品。Claude Code、Codex 等也已经开始提供移动端远程控制能力。这个市场的竞争,其实已经开始了。
我觉得未来几个月,这类工具很可能迎来一轮快速迭代。
谁能把 PC 上的深度开发和手机上的多 Agent 调度真正打通,谁就有机会抢先占领这个市场。
不过,对 Orca 这样的第三方平台来说,还有个挺现实的问题:如果将来 Claude Code 和 Codex 自己把移动端体验做得足够好了,用户还有多大必要再装一个 Orca?
挺期待接下来几个月,这帮厂商能把 Agent 的交互方式折腾成什么样。
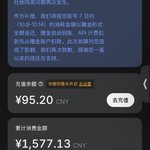
获得deepseek的200块巨额补偿,我又能爬起来干活了!


Between 8:11 and 13:04 (Beijing Time) on October 15, 2026, DeepSeek API service system experienced a failure that prevented the API service from functioning properly during that period. We sincerely apologize for the inconvenience and disruption this may have caused. We immediately launched a comprehensive investigation and thorough rectification effort focused on service stability, and have comprehensively reviewed and eliminated single points of dependency to resolutely prevent similar issues from recurring.
As compensation, we will fully refund the amount consumed within 7 days (10.8-10.14) on your account in the form of credit. The credit will be automatically deposited, and API billing deductions will be made from the credit account first. We apologize once again for the impact this failure had on you, and we thank you for your continued trust and support.
北京时间 2026 年 10 月 15 日 8:11 至 13:04 期间,我们的服务系统出现故障,导致该时段内 API 服务无法正常使用。对于此次故障给您带来的不便与困扰,我们深表歉意。我们已第一时间启动针对服务稳定性的全面排查和彻底整改,全面梳理并剥离单点依赖,坚决杜绝同类问题再次发生。
作为补偿,我们将按您账号 7 日内(10.8-10.14)的消耗金额以赠金形式全额返还,赠金自动到账,API 计费扣款先从赠金账户扣除。此次故障对您造成了影响,我们再次致歉,感谢您一直以来的信任与支持。