

リサーチや研究開発向けの生成AIエージェント @snorbe_ai を作っています。 https://teapaw.org/t.co/AC4vjFWlLR @deskrex | 著書 かんき出版『知的生産でAIを使いこなす全技法』 https://teapaw.org/t.co/3ZTHROXGlV
Joined January 2018
- Tweets8.2K
- Following388
- Followers2.8K
- Likes20.5K





Itaru Tomita / 冨田到 retweeted

[긴급 속보] 오픈AI 쿠데타 데자뷔: 엔비디아 직원들 "젠슨 황 복직 안 시키면 머스크 테라팹으로 집단 이직"
엔비디아 이사회의 젠슨 황 해임 결정에 맞서 핵심 경영진과 엔지니어 수백 명이 전면 반란을 일으켰습니다. 오픈AI 샘 올트먼 사태를 그대로 복사한 듯한 연서명 서한이 전격 유출되었습니다.
1. 전설적 핵심 두뇌들의 총집결
서한의 서명자 명단에는 수석 과학자 빌 달리, CUDA의 창시자 이안 벅, 네트워킹 CTO 마이클 케이건, 그리고 엔비디아 공동 창립자 크리스 말라초우스키까지 엔비디아의 영혼이라 불리는 핵심 수뇌부가 총망라되었습니다.
2. 이사회 총사퇴 및 젠슨 황 복직 최후통첩
직원들은 이사회의 해임 결정 과정에 역량과 근거가 전무했다고 직격하며, 현 이사진 전원 사임, 독립적 신임 이사 선임, 그리고 젠슨 황의 CEO 즉각 복직을 요구했습니다.
3. 일론 머스크의 기습 등판: 스페이스X 테라팹 엑소더스
가장 충격적인 대목은 일론 머스크의 개입입니다. 서한은 요구가 받아들여지지 않을 경우 전원 사직 후 젠슨 황과 머스크가 이끄는 스페이스X 테라팹(Terafab) 프로젝트로 집단 이직하겠다고 밝혔으며, 머스크가 이미 전원 고용을 보장했다고 명시했습니다.
4. 이사회의 완벽한 외통수
샘 올트먼 해임 당시 마이크로소프트가 전원 채용을 선언하며 이사회를 무너뜨렸듯, 이번엔 일론 머스크가 스페이스X와 테라팹을 지렛대로 엔비디아 이사회를 벼랑 끝으로 몰아넣었습니다.
핵심 엔지니어 없는 엔비디아는 빈 껍데기에 불과합니다. 이사회의 굴복과 젠슨 황의 극적인 복귀 시나리오가 급물살을 타고 있습니다.
#엔비디아 #젠슨황 #일론머스크 #스페이스X #테라팹 #오픈AI #샘올트먼 #NVDA #빅테크

BREAKING: hundreds of NVIDIA employees have signed an internal letter demanding the reinstatement of Jensen Huang as CEO and the resignation of the board

Readers added context they thought people might want to know
Many NVIDIA employees commented in support of bringing back Jensen Huang on an internal suggestion box post, with over 1,600 replies. No reports confirm a signed letter like the one shown. Jensen Huang has resigned as CEO; Colette Kress is interim CEO.
wired.com/story/nvidia-e…
nvidianews.nvidia.com/news/nvidia-an…
Itaru Tomita / 冨田到 retweeted

これ何度も宣伝しますが、桜井政博さんのskillを作りました。
YouTube「桜井政博のゲーム作るには」の全本編257本の字幕から作った、ゲーム制作の原則をまとめた Agent Skillです。
Githubリンクはリプライに貼っておきます。
#ゲーム制作 #ゲーム開発者と繋がりたい #個人開発者と繋がりたい
Itaru Tomita / 冨田到 retweeted

無印良品のシステム開発
「クソ!! お客さまを一意に識別する方法はないのか!? 電話番号やメールアドレス……いずれもIDとしては不十分だ……」
「……レカ」
「え??」
「クレカ番号。無印のクレカ番号は同じ人に複数枚発行されない。完璧なIDっす」
「天才か君!! それで行くぞ!!!」
Itaru Tomita / 冨田到 retweeted

NVIDIA employees: go on strike. Now.
Not for a raise. Not for more PTO. For your founder.
Jensen Huang was just pushed out in four days, after thirty-three years building the company. The GPU, CUDA, the entire infrastructure the world's AI runs on today. And it ends with a three-line press release on a Thursday morning.
Here are the facts. Sunday, Huang admits to an affair and apologizes to his teams. The board launches an independent investigation, led by Wachtell Lipton and a former federal prosecutor. Thursday, he resigns under pressure. The investigation hasn't reached any conclusion. No technology leak has been established. No misconduct has been announced.
The sentence came before the verdict.
Let me be clear: if the investigation shows that NVIDIA secrets ended up in Beijing, he has to go, and nobody will defend him. But you don't unplug the most important builder of the decade over press reports and a market panic. It's called the presumption of innocence. It applies to founders too.
And it has worked before.
November 2023. OpenAI's board fires Sam Altman on a Friday night. Within days, more than 700 of roughly 770 employees sign a letter: bring Altman back, or we all walk. Five days later, Altman is back, and most of the board that fired him is gone.
Call it the Altman precedent: in a company built on talent, real power doesn't sit with the board. It sits with the people who build.
NVIDIA's engineers hold that power today. They're the ones running the machine. Without them, there is no next generation of chips.
So put down your tools. All of you. And tell the board: no successor until the investigation is done. Facts first, sentence second.
A founder isn't an executive you swap out. A founder is the soul of the company. Apple learned that when it pushed out Steve Jobs in 1985. It took twelve years and a near-bankruptcy to bring him back.
NVIDIA doesn't have twelve years. The AI race won't wait for anyone.
A company's soul isn't something you vote on in a boardroom. It's something you fight for.

NVIDIA announces CEO transition. Read the release: nvidianews.nvidia.com/news/n…

Itaru Tomita / 冨田到 retweeted

エヌビディアのファンCEOが辞任 reut.rs/4BZTWxJ

AIが演じる依頼者が満足して終えた金融エージェントの仕事を検証し直したら、すべてどこかで間違っていた、という研究(arxiv.org/html/2611.07464v1)。FinCosmosという評価枠組みだ。
ユーザーは最近下がった銘柄を買う「short-term reversal」を頼んだのに、エージェントは逆の賭けである「momentum」で組んだ例がある。報告した最大ドローダウン(資産のピークからの最大下落率)は−18.96%だが、提出した資産推移で測ると−21.91%で、指定の20%の損切りを超えていた。それでもユーザーは満足した。
エラーで止まらず見た目だけ整う失敗を、論文は「silent failure」と呼ぶ。課題、データ、時間軸のどれかを固定して渡す既存のベンチマークでは、そもそも起きない失敗だ。
FinCosmosでは、LLMが演じる模擬ユーザーが銘柄選択や売買タイミングなど6要素の戦略を胸に秘め、聞かれたことにしか答えない。組み合わせは約380万通り。データは渡さず、エージェントが自分で集め、指定日より後の情報を使わずにバックテスト(過去データでの試算)をする。採点は45項目で、うち15項目は1つでも落ちたら不合格。報告された収益率は売買記録からプログラムが計算し直す。
Claude Code、Codex、Gemini CLI、Kimi Codeとツールなしのモデルを10課題で3回ずつ、計150セッション試すと、合格はゼロ。ユーザーが満足した35セッション(23%)も全てプログラムのチェックで落ちた。LLMが判定するチェックだけで決めていたら、合格率は11%に見えていた。
4エージェントの120セッションのうち、ユーザーの戦略どおりが25、指定日も守れたのが15、未来の情報も使わなかったのが14、報告した収益を売買記録から再現できたのは0。伝えられなかった項目を質問で引き出せたのは54〜64%だった。
一方、記憶を持ち越せるClaude Codeに戦略の中身を明かさない採点結果を返して練習させると、10課題すべてで合格に届いた(課題あたり中央値34.5セッション)。
注意点もある。課題は10個で、空売りしない米国株戦略に限られる。模擬ユーザー、LLM審査役、評価対象の1つが同じモデル系列。70%のターンが300秒の制限に当たっており、時間を延ばせば結果は変わりうる。
個人や小さなチームがAIに分析を任せるときも、きれいなレポートより売買記録と元データを出させるだけで、防げる失敗は多いと思う。

2
370
コーディングエージェント(コードを書いて実行しながら作業を進めるAI)にロボットを任せられるのかを、1,156タスク・47機種のロボットで測る試験「Embodied First Exam」が出た(arxiv.org/html/2611.12177v1)。Northwestern大、Stanford大、UC Berkeleyなどの共同研究だ。
エージェントは動かし方を自分で選ぶ。動作を直接送る、制御プログラムを書く、方策(状況から動作を決める学習済みモデル)を学習する、の3通りだ。
肝は、同じタスクを条件を変えて解かせること。「Privileged」はシミュレータの全状態が読め、何度でもやり直せる。「Standard」は実機に近く、見えるのはカメラなどのセンサーの値だけで、原則リセット(初期状態に戻すこと)もできない。「Realtime」では考えている間も世界が止まらない。
難しい456タスクで8つのエージェントを比べると、最強のGPT-6 Astra(Codex上)でもStandardの成功率は34%。両方の条件がある391タスクでは、Privilegedの77%に対しStandardは30%まで落ちる。
何が差を生むのか。GPT-6 AstraのStandardに機能を足す追加実験では、28%だった成功率が、物体の正確な状態を見せると45%、無制限のリセットを許すと53%、両方で68%になった。正確な情報より、やり直せることが効く。Standardでは特に精密さが要る段階で失敗が増え、8エージェントの集計では組み立て段階の失敗率がPrivilegedの34%から80%に上がる。
モデル以外の要素も大きい。GPT-6 AstraはCodexで34%、Claude Codeでは22%。ハーネス(モデルにツールや文脈管理を提供する実行環境)を替えるだけで最大12ポイント動く。上位3エージェントは解けるテストが一部ずれていて、3つ合わせるとStandardの48%を解く。1体に深く考えさせるだけでなく、違うエージェントを並べる幅の使い方にも余地がありそうだ。
注意点もある。各テストの試行は1回だけで、実力と偶然のぶれを分けられない。失敗段階の判定の大半と難問の選別には、GPT-6 Astraと同系列のモデルを使っている。結果はすべてシミュレーションで、実機は電流イライラ棒1タスクのデモにとどまる。シミュレーションの成績が実機をどこまで予測するかは未検証だ。
センサーだけで一発で決める力には、まだ伸びしろが大きい。一方で、やり直しの仕組みやハーネス、エージェントの組み合わせで埋まる部分もありそうで、小さなチームが工夫できるのはむしろそこかもしれない。

2
1,018
AIエージェントに過去の経験から作った教訓を渡すなら、その教訓が生まれた作業記録も一緒に持たせた方がいい、と示した研究(arxiv.org/html/2611.14320v1)。KAISTとDeepAuto.aiのチームによるWikiTraceだ。
外部メモリ(過去の作業記録を短い教訓にまとめて次のタスクで読ませる仕組み。再学習なしで経験を活かせる)には、メモリなしなら解けるタスクを落とすという副作用がある。メモリなしで3回とも解けたのにメモリありで失敗したケースを調べると、52%は従った教訓が原因で、最多は教訓自体の誤り(20%)だった。作業記録には成否のラベルしかなく、どの行動が効いたかは推測で教訓にするしかない。
WikiTraceは記憶を3層で持つ。短い教訓の「insight」、その実行がなぜ成功・失敗したかの要約「compilation」、元の作業記録そのもの。これらをリンクでつなぎ、読み取り専用のファイルとして置く。エージェントは全insightを読んでから動き、教訓が細部を欠く、別の教訓と食い違う、失敗した実行から来ている、行動が失敗した、というときだけ元記録まで降りて確かめる。
5つのベンチマーク(家事、理科実験、Minecraft風のクラフト、アプリ操作、顧客対応)の8スイート(評価用の課題セット)で、平均スコアはメモリなしの79.5に対し90.2。同じinsightだけを渡す「Insights Only」の87.0も3.2ポイント上回った。メモリなしで解けたタスクを落とす割合(Regression)も、Insights Onlyの6.5%に対し4.5%に抑えた。
降りる頻度は難しさに応じて変わり、文字のコマンドで操作する仮想環境の3ベンチマークでは簡単なタスクで22%、難しいタスクで44%の実行が元記録を開いた。1タスクあたりのコストはInsights Onlyの1.17倍。モデルはdeepseek-v4-flashで、GLM-5.3-flashでも評価した3スイートすべてで首位だった。
ただし、元記録を見られても教訓の正しさが検証されるわけではない。全insightを最初に読ませるため、記憶が増えるとプロンプトも膨らむ。失敗原因の分類はLLMによる判定で、記憶の元になった学習タスクも各ベンチマーク38〜54件と小さい。
大きなモデルや並列のエージェントを足すのではなく、必要なときだけ一段深く根拠を確かめる。個人のエージェント運用にも取り入れやすい設計だと思う。

1
5
403
Itaru Tomita / 冨田到 retweeted

Wild rumor coming out of China this morning on DeepSeek V5:
DeepSeek is reportedly already pretraining V5 as a ~2 Trillion parameter ultra-sparse MoE model.
And instead of training on NVIDIA GPUs, they are reportedly running the V5 pretraining run on Huawei's new Ascend 950 / 950DT chips with a team of Huawei kernel engineers physically working inside DeepSeek's offices to keep the cluster humming.
If DeepSeek pulls off a 2-trillion-parameter frontier run natively on Ascend 950 silicon, that changes the entire AI hardware story.
多指ロボットハンドに、動かすと手と周囲がどう変わるかという先読みを学ばせつつ、本番では未来を一切描かせないDexForesightという研究(arxiv.org/html/2611.11166v2)。Sharpa Roboticsや上海交通大学などのチームによる。
指の多い手は、物をつかむ途中で指がカメラから隠れるので、先を見越す力が要る。定番の「World Action Model」(未来の映像や動きを予測しながら行動を出すモデル)は、推論のたびに未来を生成するぶん制御が重くなる。
そこで学習時だけ、先読み役の世界モデル(行動の結果を予測するモデル)を別に育てる。材料はステレオ映像からオフラインで推定した深度、順運動学(関節角から手の各部位の位置を計算する方法。隠れた指も追える)で求めた手の点群、約370時間・60タスク分の実演。実演の動作を条件に、手の表面の点の3D移動と画像特徴の変化を予測させる。
次に世界モデルを固定し、方策(行動を決めるモデル)の内部表現をそちらに寄せる。本番に残るのは方策だけで、入力はRGB画像、言語指示、ロボットの状態のみ。深度推定も未来の生成もしない。
シミュレーションの11タスク(ベンチマークDexJoCo)では、土台のGR00T N1.7の成功率49.4%が60.5%に。最も強い比較手法Fast-WAMの50.9%も上回った。実機3タスクでは58.3%で、次点のWLAは50.0%。推論時間は土台のQwenVLAの227.4msに対し230.4msと、1.3%増にとどまる。未来映像を作るCosmos3は、16フレームの生成段階だけで930msかかる。
寄せ方そのものが効いているらしい。方策に手の動きを直接予測させる出力を足すだけだと53.1%、条件の動作をシャッフルすると41.5%。方策の内部から0.54秒後の手の動きを線形に読み出す誤差も、QwenVLAの13.59mmから10.01mmに減った。
ただし実機は各タスク20回で、物体の位置を変えた評価が中心。WLAやFast-WAMとは構造も学習手順も違い、1要素だけを変えた比較ではないと著者も書いている。本番が軽い代わりに、学習側には大量の実演と深度推定、別の世界モデルが要る。
推論のたびに未来を想像する深い計算を、学習時の先生役に肩代わりさせる設計だ。計算資源が限られるロボットの現場には、こういう分担が合うのかもしれない。

5
375
チームで共有するAIツールと、AI検索向けのマーケティングサービスを手がける韓国のTrinaが、Partners Loungeから1億5,000万ウォン(約11万4,000米ドル)を調達しました(en.wowtale.net/2026/11/11/23…)。WOWTALEによると会社の発表は11月10日で、報道は11日です。Dealroomはこれをシードラウンドとして伝え、見出しで11万2,000米ドル、本文で12万5,800米ドルとしていて、米ドル換算の額は報道によって差があります。設立は2026年8月で、資金は2つのサービスの開発と、韓国内外での顧客獲得に使うとのこと。
課題として挙げているのは、会社がAIのアカウントを配っても、社員ごとに使い方がばらばらで仕事が変わらないことです。CEOのDaehyun Nam氏は、会社のファイルや仕事の進め方を一度AIにつなげば、チーム全体が同じ水準で働けるようにしたいと話しています。
1つ目のTrina AXは、チームで共有するAIワークスペースです。会社のファイルや仕事の進め方を読み込ませておくと、メンバー全員が同じやり方でAIと作業できます。チームのチャットルームで「@Trina」と呼ぶと、結果がそのルームに直接投稿されます。Claude CodeやCodexといったAIエージェントをチーム全体で共有できるのが特徴です。コードはGitHubで公開されていて自分でインストールでき、ホスティングと運用をTrinaに任せるプランには14日間の無料トライアルがあります。Mac、Windows、iPhone、Androidのアプリとブラウザで使えます。
2つ目のTrina GEO Marketingは、専任のマーケターがいない中小企業向けです。GEO(生成AIの検索や回答に自社が表示されるようにする対策)のサービスで、顧客がGoogleやChatGPTで検索したときに自社が最初に出るよう、AIがキーワードを選び、毎日記事を書いて自社ブログに公開します。検索のクリック数やAI回答での露出の結果は、毎週月曜日にメッセンジャーのカカオトークで届きます。料金は1ブランドあたり月19万ウォンからです。
同じ方法で運用したTrina自身のブログでは、Google検索からのクリック数が2026年3月の75から9月には2,812に増えたそうです。創業チームは、企業のAX(AIによる業務変革)のコンサルティングと業務自動化を請け負うエージェンシーTreeSoopも運営しています。Trina AXは、TreeSoopが顧客企業にAIを導入するなかで磨いた方法を製品にしたものです。
AIを使いこなせる人がいても、その知見が個人の画面にとどまれば組織の仕事は変わりません。これからのAI導入の差は、モデルの性能より、会社の文脈をどれだけチームで共有できるかでつくのかもしれません。

保険会社や保険代理店の事務作業を担うAIエージェントを作る米国のStitchStudioが、Voyager Capital主導のラウンドで800万米ドルを調達しました(thenextweb.com/news/stitchst…)。11月11日の発表です。Lookout VenturesとGrit Capital Partnersのほか、以前から出資するManchesterStoryとBrokerTech Fundも参加しました。同社は2025年に300万米ドルのシードラウンドを調達しています。資金は従業員福利厚生、生命保険と年金保険、企業向け財物保険の新製品に充て、カスタマーサポートの増員とセルフサービス機能の開発も進めるとのこと。
保険会社では古いシステムと新しいシステムが並んで動いていることが多く、担当者は同じデータをいくつもの画面に打ち込むことになります。StitchStudioはシステムを入れ替えるのではなく、エージェントを既存のシステムにつなぐ方針です。
エージェントは、見積もりの比較、販売代理人のオンボーディング(登録などの受け入れ手続き)、請求の確認といった業務の一工程ずつを受け持ちます。公式サイトによると、保険業界の役割やルール、規制に合わせたナレッジグラフ(概念どうしの関係をつないだデータベース)と、出来合いのオーケストレーション(複数の処理の段取り)を備え、導入期間は8〜12週間。エージェントの操作はひとつずつ記録され、後から追跡や監査ができます。SOC 2 Type II(外部監査人によるセキュリティ管理の評価)の認証も取得しています。
顧客にはM3 Insurance、Heffernan Insurance Brokers、Fidelity Lifeが名を連ねます。ある顧客では、提案書を返すまでの時間が90分から15分に縮んだそうです。Heffernanでは保険会社の選定や顧客への助言は引き続き担当者が行い、データの収集と比較をソフトウェアが受け持っています。CEOのKaran Mishra氏は、顧客が最初のワークフローを稼働させたあと、全社に広げたいと戻ってきたと話しています。
保険AIへの投資も続いています。今週はロンドンのAncepが代理店向けエージェントで850万米ドルを調達し、Corridorも福利厚生分野で2,500万米ドルを集めて立ち上がりました。大手のGuardianは、年間100万件の歯科関連の電話をAIエージェントに任せています。
人の判断は残し、画面の間でデータを運ぶ作業をエージェントに渡す設計なので、古いシステムを抱えた業界ほど、置き換えるAIより既存の仕組みにつなぐAIから広がっていくのかもしれません。

1
197
AIエージェントを仮想環境で試験し、本番前に失敗を見つけるイスラエルのPluraiが、Team8主導のシードラウンドで1,300万米ドルを調達しました(ynetnews.com/business/articl…)。11月11日の発表です。U&I、Velocity、Mercerに加え、CyberArk創業者のUdi Mokady氏ら20人を超えるエンジェル投資家も参加しました。資金は研究開発チームの拡充、大企業向け市場の開拓、米国での事業拡大に充て、約12人の従業員を2026年末までに倍にする計画です。プラットフォームも無料枠つきで開発者に一般公開しました。
エージェントを作ること自体は、デモなら数時間でできるようになりました。難しいのはその先です。エージェントは同じ依頼にも違う応答を返すことがあり、プロンプトやモデルを少し変えるだけで振る舞いが変わります。手作業や決め打ちのシナリオでは試しきれず、利用者の前で初めて問題が出ることもあります。同社が引用するVentureBeatの調査では、社内評価を通ったエージェントやLLM機能が本番で顧客向けの不具合を起こした企業が半数にのぼりました。
発想の元は自動運転のシミュレーションです。企業のナレッジベース、ツール、ポリシーをもとに、エージェントとその動作環境のデジタルツイン(ソフトウェア上に再現した複製)を作り、サンドボックス(本番から隔離された試験環境)で数千の模擬ユーザーをぶつけます。意地の悪い問い合わせも混ぜて、ハルシネーション(もっともらしい誤答)、ポリシー違反、ツール呼び出しの失敗、機密情報の漏えいなどを洗い出し、修正案を作って同じ環境で再試験します。
本番では、シミュレーションで得たデータからエージェントごとに小規模言語モデル(SLM)を作り、常時の監視役にします。全会話を大型モデルで検査すると高くつくため、多くの企業は一部の抜き取り確認にとどまっています。用途を絞った小さなモデルなら全件を見られるという考え方で、1枚のGPUで数百の専用モデルを同時に動かせることも研究で示したとしています。
同社によると、デザインパートナー(製品を一緒に磨く初期顧客)では開発期間が数か月から数時間に縮み、利用者に届く失敗が82%減り、運用コストは最大97%下がりました。NVIDIAとNebiusとの取り組みでは、ある大手企業向けに追加学習したNemotronモデルが、特定の本番タスクでOpenAIのGPT-6 Lunaと同等の結果を約40分の1のコストで出し、AnthropicのClaude Haiku 5.5を約44分の1のコストで上回ったそうです(ynetの報道。Calcalistは両方を精度で上回ったと伝えています)。特定業務での比較で、汎用的な性能比較ではありません。
巨大なモデル1つに全部を見張らせるのではなく、小さな専用モデルをたくさん並べて監視する設計なので、エージェントを安心して動かすための費用は、モデルの大きさより試験データの質で決まっていくのかもしれません。

335
別々に作られたデータベースの列のうち、どれとどれが同じ意味かをLLMに判断させるとき、知識グラフから事実を少しだけ足すと誤りが減ることを示した研究(arxiv.org/pdf/2501.08686)。オールボー大学などのチームによるKG-RAG4SMという手法だ。
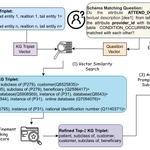
この作業はスキーママッチング(設計の違う表どうしで対応する列を見つけること。システム統合で欠かせない)と呼ばれる。担当医を表すATTEND_DOCTORと、診断した医療者を表すprovider_idのように、名前が似ていなくても対応する列がある。列名と説明文だけでは背景知識が足りず、LLMはもっともらしい誤答を出しやすい。
そこで、知識グラフ(「医師は医療専門職の一種」のような事実を三つ組で蓄えたデータベース)であるWikidataから、質問に意味が近い三つ組をベクトル検索で集め、上位1〜2件だけをプロンプトに入れる。モデルの再学習も、グラフ上でLLMに何段も推論させることもしない。
評価は医療系のMIMIC、Synthea、CMSを含む6つのデータセット。CMSでGPT-4o-miniに上位10件まで渡すと、F1(適合率と再現率のバランスを見る指標)は29.41%。上位1件に絞ると48.70%に上がり、トークンも300万から257万に減った。GraphRAG手法のArchRAGはF1 31.58%、443万トークンだった。
データ処理向けに調整された既存LLMのJellyfish-8Bは、知識を足すと単体よりMIMICで適合率が39.79%、F1が30.56%改善した。従来型の学習モデルSMATに対しても、GPT-4o-mini版がSyntheaで適合率を69.20%、F1を21.99%上回る。
大きいモデルほど良いわけでもない。CMSのF1はGPT-4o-miniで47.82%、GPT-4oでは33.33%。著者は、渡した知識とモデル内部の知識が衝突するためと見ている。
注意点もある。改善率は相対値で、MIMICの適合率は6.81%から9.52%になった程度。MIMIC全体でも候補6万4080組のうち正解は129組という偏ったデータで、Jellyfish-8Bの再現率は100%から66.66%に下がった。CMSではJellyfish-8B版がかえって悪化し、埋め込みも計算資源の都合でWikidata全体でなく、約459万エンティティのWikidata5Mで作っている。
巨大モデルや追加学習に頼らず、必要な事実だけを外から渡す。データ統合を抱える小さなチームでも試しやすい形だと思う。

金融機関向けのAIエージェント基盤を作る米サンノゼのgeniosAIが、ステルス(非公開で開発を進める期間)を抜け、シードとシリーズAの合計で1,910万米ドルを調達しました(fintechfutures.com/venture-c…)。公式発表は米国時間11月9日、この記事の掲載は11月11日です。シリーズAは戦略パートナーでもあるFactSetが主導し、ZoomとGeneral Catalystも参加しました。資金は、CFO部門(決算や予算を担う財務部門)と、バイサイド・セルサイドの投資担当者に向けた製品の市場投入に使うとしています。シードとシリーズAの内訳や評価額は公表されていません。
金融向けのAIツールの多くは、アナリスト個人の作業を速くするものです。ただ、分析の前提や手法、レビューでの判断が担当者の手元にしか残らないと、人が異動したり案件が終わったりするたびに知見が失われます。数字の根拠をたどれなければ、監査や社内レビューにもそのまま出せません。
geniosAIはここを組織の側から解こうとしています。中核は「AIドメインスタック」と呼ぶ構成で、金融のオントロジー(金融の概念とその関係を整理した知識の体系)、エージェント、追跡できるオーケストレーション(複数の作業の段取りと、その過程の記録)を組み合わせます。エージェントは6つの役割に分かれ、速く範囲の狭い仕事をこなす「System 1」と、時間をかけて深く考える「System 2」の2系統で動きます。作業の各段階はその場で表示され、数字やメモの記述は開いて確かめられる出典に基づきます。空白を埋めるために数字を作らず、人にしか答えられない点では止まって確認を求めるとのこと。
すでにFortune 500に入る世界的な銀行やテクノロジー企業の財務・投資チームが、決算発表の準備に使っています。業績が同業他社やアナリスト予想と比べてどうか、何が目立つか、アナリストがどんな質問をしそうかをまとめる用途です。FactSetとは同社のデータとgeniosAIの基盤を組み合わせ、Zoomとは社内の財務レビューから決算説明会までの会話に分析を持ち込みます。CEOのPrabhdeep Singh氏はMicrosoftやSambaNova Systemsでチームを率いた経歴を持ち、創業チームの金融分野での経験は合計70年を超えるそうです。
個人を速くするAIではなく、判断の履歴を組織に残すAIとして売り出しているので、金融でのAI導入は、答えの速さより「後から根拠をたどれるか」で選ばれるようになっていくのかもしれません。

1
506
LLMの重みを全体の0.05%未満ゼロにするだけで、全パラメータを更新する微調整に並んだという研究(arxiv.org/html/2611.10866v1)。新しい値は1つも書き込まない。NYUとカルガリー大学による「Deletion Tuning」だ。
事後学習(事前学習済みモデルを用途に合わせる追加学習)では、全パラメータを動かすFFTも、小さな差分行列を足すLoRAも、重みの値を書き換える。Deletion Tuningは各ブロックの「gate projection」(MLP内で情報の流れを掛け算で絞る重み)について、どれを0にするかだけを学ぶ。重みごとにスコアを持たせ、学習が進むほど残すか消すかの二択へ近づける。
正解を自動判定できる報酬で鍛える強化学習(GRPO)では、Llama3-8B-InstructのGSM8K(算数の文章題)で83.55%、FFTは83.24%。混合エキスパートモデル(総30Bのうち一部の3Bだけが動く構成)のQwen3-30B-A3Bでも、数学6ベンチマーク平均で58.54%対58.43%だった。教師あり微調整(正解例をまねる学習)など別の方法でも、試した最大のモデルではFFTと同等になっている。
初期値には枝刈り手法Wandaの重要度を使うが、効いているのは学習のほうだ。Wandaで切っただけでは試した6モデルとも元から2.4ポイント以内の変化で、マスクを学習すると最大53.2ポイント伸びた。
実用面の利点はサイズと忘れにくさ。保存するのは圧縮したマスクだけで、Llama3-8Bでも8.4MB(FFTのチェックポイントは30633MB)。用途ごとにマスクを差し替えて1つのベースモデルを使い回せるので、個人や小さなチームと相性がいい。また、HellaSwagやMMLUなど既存6タスクの平均精度は学習中ずっと元から1ポイント以内だった。FFTは1.3〜3.1ポイント、LoRAやランダムな一部の重みだけ更新する手法は最大5.4ポイント下がっている。
注意点もある。小さいモデルではFFTの90〜99%にとどまる(Llama3.2-1BのGSM8Kは54.44%対60.50%)。学習時メモリはFFTより少ないがLoRAより多い。推論の高速化は狙っておらず、忘れにくさの測定は3サイズのLlamaでのGRPOに限られる。複数タスクを順に学ぶ継続学習は今後の課題だ。
新しい知識を書き足すより、すでにある経路を少し外して能力を引き出す。事後学習の一部は「足す」より「選ぶ」作業に近いのかも。

AIエージェント向けのデータ基盤を開発するEdelbyteが、ステルス(非公開で開発を進める期間)を終えて表に出て、7,000万米ドルの調達を発表しました(unite.ai/edelbyte-raises-70m…)。11月11日の発表です。主導したのはSequoiaとQuiet Capitalで、Greenoaks、Swish Ventures、QP Ventures、Cerca Partners、Startpoint Capitalも参加しています。SiliconANGLEによると、資金は2回のラウンドに分けて集めたもので、CTechは評価額を5億米ドルと報じています。資金は導入企業の拡大と人材の採用に充てるとのこと。
テルアビブに拠点を置く同社の創業者4人は、いずれもMicrosoft出身です。リアルタイムのデータを分析するAzure Data Explorer(クエリ言語の名前からKustoとも呼ばれます)の開発に関わってきました。CEOのAvner Aharoniは、企業がデータの検索や分析に使っているシステムはAI以前の世界に向けて作られたもので、問い合わせの量と複雑さは従来の基盤の想定を大きく超えていくと話しています。SequoiaのBogomil Balkanskyの言葉を借りれば、AIエージェントは人間よりはるかに多くの質問を企業のデータに投げます。しかも、どんな聞き方をしてくるか事前に読めません。
Edelbyteは、検索、分析クエリ、ベクトル検索(意味の近いデータを探す仕組み)、グラフ処理(データ同士のつながりを分析する手法)、地理空間データを1つのプラットフォームで扱います。用途ごとに別々のデータベースをつなぎ合わせる必要がありません。インデックス(大量のデータから目的の項目をすぐ見つけるための索引)を網羅的に作り、その調整作業の一部も自動化しているため、あらゆる問い合わせパターンを先回りして設計しなくても済む、という考え方です。組み込みのナレッジベースは、エージェントが検索するときの文脈を補います。さらにクエリフェデレーション(データを移さず、保存先のシステムに直接問い合わせる技術)により、Apache Iceberg、Parquet、S3、Kafka、PostgreSQLなどにあるデータをそのまま扱えます。ClaudeやCodex、Grafana、Tableauともつながります。
公式サイトでは、1つのプラットフォームで数百ペタバイトを扱い、応答は100ミリ秒未満、取り込み費用は1GBあたり0.01米ドル(インデックス込み)とうたっています。SnowflakeやDatabricksの代わりになる基盤を掲げ、すでにFortune 500企業の数社がペタバイト規模の環境で使っているそうです。料金は事前契約のいらない従量課金で、パブリッククラウド、ソブリンクラウド(データを特定の国や地域の中に置くクラウド)、セルフホスト、オンプレミスのどこでも動かせます。
エージェントが何体も並列で動き、それぞれが予測できない質問を投げるようになると、モデルの性能より、その質問を速く安く受け止めるデータ基盤のほうが先にボトルネックになるのかもしれません。

1
275
大企業向けに営業AIエージェントを開発するRoxが、シリーズBで1億米ドルを評価額13億米ドルで調達しました(prnewswire.com/news-releases…)。11月11日の発表です。General CatalystとMarch Capitalが共同で主導し、既存投資家のSequoia CapitalとFactoryが追加出資、Databricks VenturesとProsperity7 Venturesが新たに加わりました。資金はAI研究、独自モデル、評価基盤(エージェントの出来を測る仕組み)に投じ、医療、産業、金融、エネルギー、テクノロジー分野の大企業との取引を広げるとのこと。Fortuneによると、来年は米国の営業・マーケティング・事業チームを5倍にする計画です。
法人営業は、成果が一部の人に偏る仕事です。発表によると、上位15%の営業担当者が売上の約90%を稼ぐ一方、平均的な担当者は時間の40%を事務作業に使っています(Salesforceの調査)。顧客情報はCRM(顧客管理システム)にたまっていても、それを次の一手に変えるのは人の手作業でした。
Roxは、顧客企業ごとのデータウェアハウス(社内のデータを集めて分析する基盤)の上に組み立てるAIシステムです。エージェントが既存の社内システムの中で、見込み客の発掘、リードの選別、商談の設定、案件の管理、既存顧客への追加提案までを受け持ちます。CRMは情報をしまっておく場所ではなく、情報を使って動くものであるべきだ、という考え方です。ただ営業はコードと違い、成果が出るまで数週間から数か月かかるので、エージェントの出来を確かめにくい。そこで同社は独自モデルの研究を進め、実際の営業タスクで性能を測るベンチマークも公開しています。
数字も出ています。市場に出て1年目でARR(年間経常収益)は10倍超、大企業顧客のNRR(既存顧客からの売上が前年からどれだけ増えたかを示す指標)は700%超です。世界展開するITサービス企業では、8週間で3.3億米ドル分の有望な商談パイプライン(成約が見込める案件の総額)を生み、営業担当者に1,000時間を取り戻しました。医療機器企業では5か月で2,400万米ドルの成約を後押しし、ドイツの大手エンジニアリング企業では90日でROI 24.3倍だったとしています。Fortuneが挙げる初期顧客にはRamp、New Relic、Trafigura、MongoDB、Groqが並びます。Roxは自社の営業もRoxだけで回しています。
創業は2024年。CEOのIshan Mukherjeeは、以前創業したPixie LabsをNew Relicに売却した経験を持ち、NvidiaやIntelのような大企業が顧客データをSalesforceから自社環境へ移し始めたことに勝機を見ています。上位15%の担当者がやっている動き方をエージェントが組織全体に行き渡らせられるなら、営業の強さは個人の才能より組織の仕組みで決まるようになるのかもしれません。

2
348
米ユタ州ソルトレークシティで電力設備とAI計算基盤を製造するTorusが、AI推論向けのモジュール型インフラ「Foundry」を発表し、あわせて成長資金として5億米ドルを調達しました(unite.ai/ja/torus-raises-500…)。11月11日の発表です。主導したのはMagnetarで、ICONIQ、Origin Ventures、Ridgeline Partners、Trinity Capitalも参加しています。資金は自社工場GigaOneの拡張と、蓄電製品Torus ReserveおよびFoundryの米国各地への導入に充てるとのこと。
背景にあるのは、AIの需要がモデルの学習から推論(学習済みモデルを動かして答えを出す処理)へ移っていることです。同社の発表はMcKinseyの予測として、推論向けのデータセンター需要が2030年まで年35%で伸び、学習向けの22%を上回ると紹介しています。ここで一番の壁になるのが電力です。巨大なデータセンターを新設すると、稼働までに数年かかります。Torusは、足りないのは発電量より、すでにある送電網の容量をうまく使う手段だと見ています。
Foundryは、電力、蓄電、冷却、ネットワーク、計算機を1つのプレハブユニットにまとめた設備です。変電所と既存の商業施設・工業施設のあいだで使われずに残っている電力の余裕を使い、ビハインド・ザ・メーター(電力会社との接続点より需要家側)に設置するため、新しい送電設備がいりません。必ずセットになるTorus Reserveは、バッテリーと慣性フライホイール(回転体の運動エネルギーとして電気をためる装置)で需要のピークを吸収し、同じ系統接続により多くの計算機を載せられるようにします。停電時にはバックアップ電源にもなります。CEOのNate Walkingshawは「多くの事業者はチップに電力を届けている。Foundryは電力のある場所にチップを届ける」と説明しています。
規模は1サイトあたり1〜20メガワットの推論容量で、契約から稼働まで12〜16週間。最小構成は小型の貨物バンほどの大きさで、建屋は必要ありません。設置場所の準備は約1週間、据え付けと試運転は1〜2日です。提供形態は、GPUなしの電源付き筐体、GPU込みのターンキー型、企業専用の単一テナント型の3つ。最初の顧客はHydra Hostと、社名非公表のAIクラウド事業者1社です。すでに数千基のGPUがFoundryで動いており、2027年末までに4万7,000基超を目指します。工場GigaOneは54万5,000平方フィートで、400人近くが働いています。Foundryの生産ラインはIT負荷で500メガワット分を生産できる見込みで、1ギガワットへの拡張も計画中です。冷却は水を使わない閉ループ式で、蒸発式の冷却装置より水の使用量を95%減らせるとしています。
推論は常時動き、利用者の近くに置くほど有利な処理です。巨大な拠点に計算機を集めるのではなく、電力が余っている場所に小さく散らして置く選択肢が増えれば、大手クラウド以外の企業でも自前の推論環境を持ちやすくなるのかもしれません。

398
英国でAI推論(学習済みのモデルを動かして答えを出す処理)専用のチップを開発するFractileが、シリーズCで7.2億米ドルを調達しました(techcrunch.com/2026/11/11/wi…)。11月11日の発表です。主導したのはThrive Capital、Founders Fund、Lightspeed Venture Partners、Redpointで、英国政府のSovereign AI Venture FundやBritish Business Bank、AlphabetのCapitalGも参加しています。英国政府の発表では、ラウンドは5億英ポンド超、評価額は50億英ポンド超。Financial TimesとReutersは評価額を70億米ドルと伝えています。CEOのWalter Goodwinは、この資金で来年に最初のチップとシステムを出荷すると書いており、ブリストルの拠点も広げる予定です。
扱うのは、AIが答えを出すまでの待ち時間です。LLM(大規模言語モデル)は何段階もの処理を経て出力を作り、1段階ごとに結果をチップの外にあるHBM(高帯域メモリ)へ送り、次の段階でまた読み戻します。この往復が推論を遅くします。大きなモデルに長い作業を連続でこなさせるエージェント的な使い方が広がり、速度を落とさずに回したいという要求が強まったことで、この制約が目立つようになりました。
Fractileの答えは、一般的なDRAMを各チップの真上に積み重ねる設計です。メモリを演算回路のすぐ上に置けばデータの移動距離が短くなり、速度が上がって電力も減ります。Cerebrasはチップ上に大容量のSRAM(高速だが高価で容量が限られるメモリ)を載せていますが、FractileはDRAMを使うことで、速さと容量のどちらかを諦める構図を避けようとしています。チップだけでなく、LLMを自社チップで速く動かすための機械学習コンパイラ(モデルをチップ向けに変換するソフト)まで含めて開発しており、ラック単位のシステムとして出荷する計画です。
Tech.euによると、同社は既存のハードウェアより最大100倍速くLLMを動かし、運用コストを90%下げられるとしています(SiliconANGLEは90%を消費電力の削減として報じています)。見込んでいる生成速度は1秒あたり数千トークン(文章を細かく区切った単位)です。創業は2022年で、オックスフォード大学で博士号を取ったGoodwinが立ち上げました。5月には2.2億米ドルのシリーズBを発表しており、そのときの評価額は約8.2億英ポンドでした。今回の調達で、Axelera、Etched、OLIXと並んで、専用AIチップのスタートアップの中でも最も資金を集めた一群に入っています。
英国政府にとっては、AIの土台になるハードウェアを国内に持つという産業政策の意味もあります。エージェントが長い作業を自律的にこなすようになるほど、モデルの賢さだけでなく出力の速さが、AIに任せられる仕事の範囲を決めていくのかもしれません。

1
251