

早稲田大学政治経済学部卒。株式会社プリンシプル取締役 フェロー。 GA4(共著と単著)、Tableau、SQL、データポータルのすべてについて著作のある唯一の日本人。個人ではUdemyで講座を展開しています。|趣味・興味:ゴールデンレトリバー、水泳、イタリア語、スペイン語、釣り、料理、お酒、お菓子作り
Joined May 2009
- Tweets4.1K
- Following616
- Followers5.1K
- Likes13.5K




イタリア語検定3級・4級を併願受験する学習日誌をはじめました📝
モチベ継続にプラスなはず! > 自分
自作の対策アプリ(無料公開中)も作りました。何しろ問題を数多く解くのが合格の近道という判断です。このアプリで学習した実データで、合格までの記録を週1で公開していきます🇮🇹
#イタリア語 #イタリア語検定 #語学学習
itaken3.learn-k.net/blog/202…

木田 和廣 | 日本で唯一のGA4/Tableau/SQL/データポータル全部について本を書いた人 retweeted

自分が最初に使ったツールは自社開発のものでしたが、後にSiteCatalystが導入され、支援側へ転職後はGAはもちろんRTmetricsやVisionalistなど、色々お世話になりました。
→ アクセス解析の歴史【第1期 1990〜2004】黎明期ツールの進化と変遷 | Web担当者Forum webtan.impress.co.jp/e/2026/…


a2iと、Web担さんで、同じ「振り返り」を並行展開中。
両方にお世話になってきたから、胸熱!!

この企画のフル年表をa2iで公開しました。皆さんはどの時代からの参加でしょうか? また、年表の漏れ、追加して、修正して等は、このページの最後に通報ボタンがありますので、ぜひご協力お願いします。
a2i.jp/special/final/ahistor…

6
369
仕事が自分に合っているかの見分け方として、これは間違いない。
また、自分だけかもしれないが、Garminの「Body Battery」(元気度を示す指標)にも表れる。合っている仕事をしているときは、数値が良くなることがある。つまり、仕事をしたら元気になる😊
ログを取り続けていると、こういうデータも判断材料になるかもしれない。

いまも毎日のように使っている「UTMパラメーター」。
このUTMは「Urchin Tracking Module」の略で、1998年に登場したアクセス解析ツール「Urchin」の名前が残っているんですよね。
「直帰率」の名付け親は石井研二さん、という話も出てきます。
そんなアクセス解析30年の歴史を、大内範行さん(@ouchicom)と振り返る対談が、Web担当者Forumで始まりました😊
第1期は1990〜2004年、サーバーログの時代から。
webtan.impress.co.jp/e/2026/…


Googleが、会話分析エージェントの利用状況を可視化するデータポータルのテンプレートを出してきた😊
会話ログを有効にしていれば、会話分析ログを格納しているテーブルのフルパス(プロジェクトID.データセットID.テーブルID)を入れるだけで、自動で作ってくれるよ😆
googlecloudplatform.github.i…


おおよそ賛成。。。なんだけど、DWH側に可視化機能が吸収される。という見通しについては私は懐疑的です🤔
手元で、ドラッグ&ドロップベースで、サクサクと可視化していく気持ちよさと、気づきを得るまでの速さは、いまの感じではクラウド側の機能ではちょっと難しいのかな?と😅

すごくいい取り組み。。。だと思った反面、あれ?3年前(5年前?)の記事かな?とも思った。

"Tableauの導入により、これまで手作業に依存していた業務の効率化だけでなく、必要な情報へ迅速にアクセスできる環境が整い、データに基づく意思決定の高度化が進んでいる"
横浜銀行、「タブロー」でM&A候補先選定工数の6割削減を目指す - ZDNET Japan share.google/ZUv5hwgGiB6B12L…

△
▽
のUIは、よーく考えると少し混乱することがあって、いま、1階にいて、3階に行きたいとする。
ま、普通は△を押すよね、ところが、「わたしの乗るカゴが(いま、上のどこかの階にいるんだろうが)下に来てほしい。と思えば▽も成立する気がする。
ま、考えすぎだとは思うけどね😅
海外いたとき、両方のボタン押してとりあえずカゴを止めて、止まったら中にいる人に「これ、下(あるいは上)に行きますか?」と聞いてから乗る。という人々を見たことある😂

1
679
> 「卵は一つのカゴに盛るな」は、投資ポートフォリオとして当然のことなんですが
そうなんだよね、けど、企業運営や個人のキャリア開発においては、卵(=自社や自分の可処分リソース)を、複数のカゴに盛ると、突き抜けられない。
とすると、ミドルリスクミドルリターン(複数のカゴ方式)でいくか、ハイリスクハイリターン(あえて一つのカゴに盛る方式)を決めなきゃいけないってことかなぁ。
私自身は、職人タイプなので、一つのカゴ派。で、盛るカゴをどんどん切り替えていく派😁
7
501
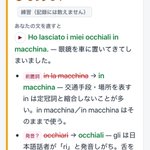
自作アプリ。
簡単な日本語をアプリに表示させて、それを瞬時にイタリア語で発声するドリル。
わしの、メガネ(occhiali )の発音が、
occhiariになってるよ!と、ダメ出しされた。
この聞き取り能力、すごくない???😳

1
6
400
イタリア語学習支援アプリ制作ノウハウをもとに、次は、アニメのセリフを利用した日本語学習支援アプリを作ろうと思ってたんよ。
アブねnikkei.com/article/DGXZQOUA0…
1
4
311
明日は、JADEの長山さんと対談です。
1⃣BigQueryはいつ使い始めたのか?
2⃣BigQueryのどこが好きなのか?
3⃣なぜ、BigQueryについていこうと決めたのか?
などを(もし、聞かれたら)お話しようと思ってます😀
うまくいくと、広い意味で、「テクノロジーに伴走する形でのキャリアの広げ方」みたいな話しになるかもしれません。対談はナマモノだし、事前打ち合わせゼロなので、わからないけどね😊
---
また、わたし、ここ半年ほどイタリア語を熱心に勉強しているのですが、その理由を探るような話しにもなるかもしれません(ならないかもしれません😅)
もちろん、イタリアやイタリアの食事、イタリア語が好きだから、、、なのですが、実は生成AIの登場とも関係しているんです。
生成AIの登場がなぜ、イタリア語の学習につながるのか・・・興味がある方はぜひ、お聞きください。

明日の #JADEふらっとトーク、ゲストに木田和廣 @kazkida さんをお迎えします! JADE長山 @KazushiNagayama とWeb解析やBigQueryのことを話してくださるはず…イタリア語の話も聞きたいです。
いつも通り15:15〜です。ぜひお耳のおともによろしくお願いします!
youtube.com/live/feml0idfSjU


8月27日に開催された、Web担主催の「生成AI × マーケティング フォーラム 2026」での登壇内容を記事にしてもらいました。
こんなことを話しています。
1⃣ GA4のデータを生成AIに「会話で」分析してもらう3つの方法と、その優劣比較
2⃣ リッチな「文脈」をUIから簡単に登録できるから、BigQueryの会話分析が最強
3⃣ 今後、マーケターの仕事に「会話分析エージェントを作り、育て、社内に布教する」というのが入ってくるんじゃない?!
webtan.impress.co.jp/e/2026/…

ブログを書きました。
kazkida.com/bq-conversation-…
BigQueryの会話分析(自然言語でデータに質問できる機能)で、10月26日から「会話ログ」が正式提供になりました。ノーコードで作ったデータエージェントでも、設定を一つ入れるだけで、利用者との会話の記録がBigQueryのテーブルに自動で溜まるようになった、という話です。
続いて11月2日には、エージェントの利用状況を見る「モニタリング」画面も正式提供になりました。1週間で2つのリリースです。
Googleがエージェントの「運用」フェーズに対応する仕様を本気で組み込み始めた、と感じています。
ログが溜まるなら、分析だよね、ということで自分のエージェントで会話ログを有効化し、数日分のログを読んで、こんな形で分析できる、という記事にしました。
書いたのは主に3つです。
1⃣ ログにどんなカラムが残るのか(17列の一覧つき)
2⃣ ログのクセ
・質問と回答の1セットが5〜7行に分かれること
・「セッション」の意味がGAと違うこと
・トークンが特定の行にしか記録されないこと
3⃣ エージェントの通信簿であるこのログの読み方
マーケターにとって、エージェントを「作る」仕事の先に「測って育てる」が加わってくる。そんな気がします。
正式提供から1週間の機能なので、日本語の解説はまだほとんど無いと思います。会話分析のエージェントを作ったことがある方、これから作る方はぜひ。
#BigQuery #会話分析 #AgentAnalytics
kazkida.com/bq-conversation-…
