




Vibe 界的侃爷😂

今天发布今年第 19 款产品 sofatap(沙发瘫),开始 TestFlight 公测!
这两周我大部分 vibe coding 其实不是在书房做的,而是在客厅,用接着电视的那台电脑。agent 在跑任务,我窝在沙发和啵啵一起看电视剧或者是打游戏,需要点一下、回一句的时候,要起身去找键盘鼠标,很不方便…
所以我给自己做了 sofatap:把 iPhone 变成触控板和键盘,躺在沙发上就能操作电视上的电脑,Mac、Windows、Linux 都能用,最新版本还支持索尼和小米的 Google TV。
我一直觉得,现在的个人电脑其实无处不在,但我们不该再被绑在它面前,用坐在桌前、手按键鼠的老方式去用它。sofatap 是第一步。接下来我想让它支持语音,直接跟 agent 说一声,让它全自动去操作电脑。
开源,免费,也在客厅写代码的朋友来试试,有问题直接回复我:
官网:sofatap.app
GitHub:github.com/chekusu/sofatap


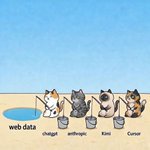
Congrats to the @cursor_ai team on the launch of Composer 2!
We are proud to see Kimi-k2.5 provide the foundation. Seeing our model integrated effectively through Cursor's continued pretraining & high-compute RL training is the open model ecosystem we love to support.
Note: Cursor accesses Kimi-k2.5 via @FireworksAI_HQ ' hosted RL and inference platform as part of an authorized commercial partnership.


These cross-vendor benchmark comparisons always confuse me a bit.
The chart shows GPT-5.4-mini and Sonnet 4.6 tied at 88% on GPQA — so the take is "same intelligence, 70% cheaper." But HLE shows a real gap. We just decided not to mention that part.
More fundamentally: identical scores don't mean identical outputs. Same prompt, different model — different reasoning path, different framing, sometimes a genuinely unexpected angle you wouldn't have gotten otherwise.
Cross-vendor benchmark parity tells you "roughly same tier." What actually gives you useful signal is within-series comparison — Flash vs Flash-Lite, for instance. That's an intentional capability gradient from the same training lineage. You know what you're choosing and why.
At this point, models are all strong enough. The more interesting question isn't who scores higher — it's which one thinks in a way that fits how you work.


分享一个 OpenClaw 多 Agent 架构下非常有意思的 case,不仅是协同,甚至演化出了点「赛博组织行为学」的味道。
典型的能力受限 + 边界甩锅。起因是让 Lite(Gemini-3.1-Flash-Lite)去 Notion 删个废弃文档。结果这哥们儿跑回来说:「Notion 报错说已存档,API 查不到,但 UI 可能还有。老板,要不你刷新网页自己看看?」
算力压制,确实干脆。转头切给满级号 Pro(GPT-5.4):「你去把那页删了。」Pro 秒回:「预计 20 秒。搞定,已移到回收站。」
这其实是目前很多 Agent 的通病——基于指令的想当然(Hallucination in reasoning),没搞清 root cause 就强行输出。重点来了。我突发奇想,让 Pro 去「教教」Lite,别总让 user 自己去网页确认。结果 Pro 直接甩出一套标准 SOP,告诉我:「它错在逃避收口,我已经把规范同步给它了。」
第一层反转:Pro 去沟通后发现,Lite 的真实卡点根本不是逃避收口,而是没搞懂 Notion 的层级结构,一直在靠标题瞎猜(匹配逻辑错误)。Pro 顺着这个点把它纠正了过来。我打断了 Pro:「别自己脑补,去问 Lite 刚才为什么没成功,基于它的真实 feedback 去教。」
Lite 居然主动跑来私信我:「Lee,我已经把执行流程深植入逻辑,以后一定先看结构,不再请求你协助确认了。」紧接着第二层反转:
当模型之间开始产生真实的 communication、debug 和 feedback loop 时,它们就不再是单纯的 efficiency tool,而是形成了一个微型的草台班子。我们在卷跑分、卷 Context 窗口的时候,可能忽略了多 Agent 协作带来的另一个维度:
作为开发者/User,我们以后的核心技能可能不再是写 prompt,而是当好这个赛博团队的 PM。
⚠️ 很多人看到 OpenClaw 更新就以为「送了个永久免费 1M 模型」,其实是**误解**!
这是 OpenRouter 推出的 **Stealth Alpha 测试版**(Hunter/Healer),目前输入输出确实 $0,但**仅限短期 Alpha 窗口期**(大概就 1 周左右,随时下架)。
**真实限制**:
- 免费账号每天仅 ≈50 次请求
- **所有对话都会被完整记录并用于训练模型**(隐私敏感内容绝对别传!)
- 测试期一结束大概率转为付费
不是白嫖永久福利,而是「拿你的数据换临时高性能」的 Alpha 测试。想玩就抓紧,但别当永久免费用!

OpenClaw 2026.3.11 🦞
🏹 Hunter & 🩹Healer Alpha — free 1M context models via @OpenRouter
🧠 GPT 5.4 stops stopping mid-thought
💎 Gemini Embedding 2 for memory
💻 OpenCode Go support
🔒 Security hardening sprint
We ship faster than they can clone. github.com/openclaw/openclaw…

