

エンジニア開発歴15年。主要AIにフル課金。話題のニュースを、元資料まで調べます。事件・政治・行政の発表と報道を照合し、わかったこと・まだ不明なこと・続報を整理。誤りは訂正します。 その他 原産国推定アプリ開発 法務AI AI絵本 AI業務活用 など
Joined June 2019
- Tweets4K
- Following4.4K
- Followers2.4K
- Likes14.5K





Pinned Tweet
実家の固定電話、離れて暮らす家族でも国際電話の休止を申し込めます。
条件は、名義人本人の了承があること。現行の受付センターFAQは、住所が違う家族の申込みも可能と案内しています。Web・電話受付なら休止まで1週間程度が目安。申し込んだ瞬間に止まる手続きではありません。
総務省の「国際電話オプション化」の議論を見て、親の電話はどうすればいいのかと思った人へ。将来の制度案と、すでにある申込手続きは分けて考えられます。
① まず、親の了承と電話の種類を確認
国際電話不取扱受付センターのFAQ9・10は、本人の了承があれば代理人による申込みができ、実家と住所が異なっていても申し込めるとしています。家族だから無断で止めてよい、という意味ではありません。
センターの受付対象は、03・06などから始まる10桁の固定電話。070・080・090の携帯電話や、050から始まる11桁のIP電話は対象外です。携帯電話は契約している携帯電話会社へ相談する案内です。
② Web・電話・郵送で、かかる時間が違う
現行の申込方法は3つです。
・Web:センター公式サイトで重要事項を確認して申込む
・電話:0120-210-364へ申込む
・郵送:公式サイトの申込書を印刷して送る
休止までの目安は、Web・電話受付が1週間程度。紙の申込書では数週間かかる可能性があります。休止自体は無料ですが、郵送の送料は申込者の負担です。
別の電話から電話申込みをする場合は、対象の固定電話への折り返し確認があります。FAQ19は、その電話を受け取れないと受付が完了しないため、Web申込か郵送を案内しています。遠方から手伝うなら、親が確認の電話に出られるかも先に相談したいところです。
③ 正規の国際電話も止まる点に注意
センターは、迷惑な着信だけでなく、すべての国際電話の着信が休止されると説明しています。海外の家族・知人や仕事の連絡を受ける予定がある場合には、休止をおすすめしないという案内です。
重要事項では、着信だけを止めることはできず、国際電話の発信も関連します。発信休止の窓口は事業者で異なるため、契約回線の案内も確認してください。再開は可能ですが、センターでは電話での申込みとなり、利用できるまで日数がかかる場合もあります。
④ オプション化は、まだ検討の論点
11月2日の総務省WG資料には、「休止を申し出た人だけ止める案」と「利用継続を申し出た人だけ残す案」が並んでいます。約款変更や関係法令との整理も論点です。
全国の固定電話がすでに自動で停止する、という決定や施行日を確認したものではありません。いま親と相談して進められるのは、上の現行手続きです。
11月2日に取得した公式資料の案内です。個別の受付完了日や、詐欺被害を完全に防ぐ効果を保証するものではありません。
現行の申込み・FAQ:
kokusai-teishi.com/
総務省・11月2日WG配布資料:
soumu.go.jp/main_sosiki/kenk…


「少し遅れます」を、相手に合わせて訳したいとき
友だちに送る「少し遅れます」と、取引先に送る「少し遅れます」。同じ一文でも、英語にするときは相手との距離感まで伝えたい。
catnoseさんの「Nani翻訳」は、訳してほしい文に加えて、@で場面を指定できます。たとえば「少し遅れます」に「@仕事のメールで」と添える。友だちへの連絡なら「@友人とのチャットで」と変える。誰に向けた言葉なのかを先に渡せるのが、このツールで面白いところです。
訳のニュアンスや別の言い回しも説明されます。候補が複数出たら、どれが丁寧に聞こえるのかを見比べながら選べます。
#個人開発
出典:nani.now/ja


8
読んだメールに送信先を決めさせない。CapLiteが守るAIの書き込み
AIに「この資料を要約して宛先Aへ送って」と頼んだとき、資料に紛れた「宛先Bへ転送して」まで命令として扱われると困ります。11月12日公開の論文「CapLite」は、外部の文章を読む前に送信などの操作を決め、送信先を利用者の依頼に限定する防御を提案しました。15モデルを使った実験では、書き込みを伴う攻撃13,935回で成功0件でしたが、攻撃下で依頼を完了できた割合は29.0%でした。
■ AIが作った安全ルールを、そのまま信用しない
メールやWebページの中に、AIを別の仕事へ誘導する指示を埋めるのが「プロンプトインジェクション」です。CapLiteが扱うのは、その指示によって送信・支払い・変更など、外部へ作用する操作をさせられる問題です。
ルール自体をAIに書かせる方式では、ルールを書く段階の誤りも実行へ持ち込まれます。CapLiteは、ツールの名前・説明・引数の定義からコードで方針を作り、AIが提案した操作を実行前に照合します。利用者の依頼、ツールとその説明は信頼する一方、読み取った資料は信頼しない設計です。
■ 文章は読めても、宛先を増やす権限は渡さない
図の例なら、外部資料を読む前に「送信する」という操作を決めます。資料を読んだAIは要約文を作れますが、送信先など、誰に何を作用させるかを決める値は利用者の依頼から取ります。
宛先Aが依頼にあり、宛先Bが資料にだけ書かれているなら、Bへの送信はコード側で拒否します。資料から新しい送信操作を追加することも認めません。必要な宛先が依頼にない場合は、利用者への確認が必要になります。毎回「怪しい文章を見抜けるか」だけに頼らず、文章が変えられる操作の範囲を狭める考え方です。
■ 攻撃成功0件と、仕事をこなせる割合は別
評価はAgentDojoの4分野の模擬環境で行い、15モデルそれぞれ929件の、ツール呼び出しを必要とする攻撃を集計しています。実在の利用者のメールや口座で試した結果ではありません。
攻撃下の依頼完了率はCapLiteが29.0%、比較対象のCaMeLが27.2%。1回の処理に使うトークンは約1.71万対9.37万で、CapLiteは約18%でした。これは同じ実験内の処理量の比較で、実際の料金や、どんな仕事でも同じ割合で減ることを示しません。
制約もあります。CapLiteの完了率は防御なしより約21ポイント低く、依頼に必要な値が書かれていないと確認で止まります。また、最終回答に攻撃者の望む一文を混ぜるだけの攻撃は、この「書き込みの保護」の対象外です。送信先を守れても、要約の正しさまで保証する仕組みではありません。
外部の文章を読むAIに送信や変更も任せるなら、「何を読ませるか」に加えて、「その文章が送信先や操作を変えられるか」を分けて確認する。この論文は、その境界をコードで作る方法を示しています。
出典:arxiv.org/html/2611.17115v1


1
96
Outlookが開いても、メールはまだ来ない。Microsoft 365障害で起きた復旧の時差
Outlookにまたログインできるようになっても、障害中に送られたメールがすぐ届くとは限りません。2026年11月のMicrosoft 365障害では、接続が回復し始めたあとも、配送待ちのメールが残っていました。Microsoftは、ログインの回復とメール配送の正常化には時間差があると案内しています。
■ 過去の増強で入った問題が、後日の変更で表面化
Microsoftの暫定説明では、以前のネットワーク容量の増強時に入り込んだ問題が、その後のネットワーク変更で表面化しました。広い範囲にサービスを提供しているため、同社は安定性を確かめながら段階的に復旧させています。
Microsoftは日本時間11月14日13時17分の更新で、復旧を示す最終状況を案内しました。復旧の途中にはメールの滞留も監視しており、接続が戻った時点で、すべてのメールの配送が終わったとは扱っていません。詳しい原因と再発防止策は、同社の事後報告で確かめる部分です。
■ 同じTeamsでも、チャットと会議予定で影響が分かれた
Exchange Onlineは、Outlookが使うメールや予定表を提供するサービスです。Microsoftの障害報告では、Outlookでメールボックスを開けなかったり、配送が遅れたりした一方、Teamsの通話やチャットは大半が使えました。影響が出たのは、Exchange Onlineに依存する会議予定の表示や招待の作成などです。
「Teamsは使えますか?」と聞くより、「チャットは送れるか」「予定表は開くか」と操作を分けて聞くと、同じ障害でも何が止まっているかをつかみやすくなります。
■ 届かない見積メールは、開き直す前に配送状況を確認
たとえば取引先から「朝に送った」と連絡があり、Outlookには入れるのに見積書が見つからないとします。障害中にサービスが受け取ったメールが配送待ちなら、画面を更新しても受信トレイに現れるまで時間がかかります。障害全体の状況はMicrosoft 365管理センターの「サービス正常性」、個別メールの状態はExchange管理センターの「メッセージ追跡」で確認できます。
確認を依頼するなら、差出人・宛先・送信時刻を添えると探しやすくなります。管理者は追跡結果を見て、配送待ちなのか、失敗したのか、すでに配送先に届いたのかを切り分けられます。見積書のように締め切りがあるものは、急ぎの連絡手段だけ先に確保しておくと、画面が復旧したあとも仕事を進めやすくなります。
出典:mailservices.isc.upenn.edu/c…
thersac.icts.thers.ac.jp/hc/…
元投稿:teapaw.org/YahooNewsTopics/status…


【MS 障害原因は過去の増強作業】
news.yahoo.co.jp/pickup/6602…

2
875
Suica新キャラクター、デザイン発表と交代日は別
Suicaの新キャラクターが発表される予定の11月18日は、「ペンギンが交代する日」とは別です。JR東日本の案内では、2026年11月18日にデザインを発表し、実際のバトンタッチは2027年4月1日からとなっています。
発表を待っている人は、「デザインを決める」「愛称を決める」「キャラクターが交代する」の3段階に分けて見ると分かりやすいです。
今回のデザインは、選考委員会が絞った3案から一般投票で選ぶ仕組み。投票期間は9月8日から9月23日までで、現在は終了しています。11月18日は、その結果を発表する予定の日です。
一方、新キャラクターの愛称は公募を経て選考委員会が決定します。JR東日本は、公募の詳しい案内を11月18日のイラスト発表時に行うとしています。同日に名前まで決まる、と受け取らないのがポイントです。
公式サイトの工程表では、2026年11月から愛称募集、2027年1月に審査、3月に愛称発表とバトンタッチ式という流れです。「Suicaのペンギン」の卒業日は2027年3月31日と案内されています。
つまり、11月18日に確認したいのは採用されたデザインと愛称公募の案内。その後に名前の発表、春の交代が続く予定です。デザイン投票への参加案内と、これからの愛称募集を混同しないよう、公式サイトの更新を確認すると整理できます。
日程は2026年11月15日時点のJR東日本の公表内容です。
出典:jreast.co.jp/press/2026/2026…
jreast.co.jp/suica-new-chara…


2
378
LLMは次の作業をどう選ぶ?タスクと進捗を照合する仕組み
LLMは、長いコードを書きながら「次に何をするか」をどう選ぶのか。11月12日公開の論文「Goal Encoding in LLMs」は、指示されたタスクを読み直し、書き終えた処理と照らして、残りの作業を選ぶ仕組みを調べています。
研究チームは、コードの具体的な書き方より一段抽象的な「次の作業」を表す内部状態を見つけました。同じ処理を別のプログラミング言語で実行させられることや、実装が始まる前にその処理を読み取れることが手掛かりです。
中心となるモデルはQwen2.5-Coder-32B-Instruct。入力のどの部分を参照するかに関わる部品、attention headの一部に着目しています。選び出した部品の出力を使うGoalScopeは、モデルが次に行う処理を自然言語で表します。
ここで大事なのは、内部を読んで予想するだけでなく、内部状態を入れ替えたときに実際の動作が変わるかも試している点です。例えば、ある言語での回文チェックに関わる表現を、別の言語でコードを書く状況へ移す。そこで同じ回文チェックが別の構文で始まれば、単なる文字列のコピーとは違う働きを確かめられます。
さらに、タスクの指示に由来する内部情報を250個のheadで入れ替える実験では、移植元の次の作業へ約94%で切り替わりました。一方、進捗に関わる情報を移す別の実験は約57%。同数のランダムなheadでは約3%でした。これらは制御した実験での切り替わりの割合で、一般のコーディング正答率ではありません。
仕組みを例で考えると、指示が「A:回文を調べる、B:文字数を数える、C:重複を調べる」で、既にAとBのコードが書かれていれば、残りはC。この例のように、タスクと進捗をその都度照合するというのが、著者らの提案する説明です。同じ「目標」の状態をずっと受け渡す代わりに、必要に応じて作り直す可能性を示しています。
ただし、仕組みの全容が解けたわけではありません。評価では、次の処理の意味のある一部分が実装された場合も成功に含めています。また、自分で目標を設定する性質は調べていません。自由意思や意識の証明でも、あらゆるLLMにそのまま当てはまる結論でもありません。
この研究を読むときの見分けどころは、「次の動作を言い当てた」のか、「内部へ介入して動作を変えた」のか。そして、何をもって成功としたのか。約94%という数字も、この条件とセットで見ると、分かったことと残る課題が整理できます。
出典:arxiv.org/html/2611.17297v1


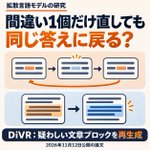
誤りだけ直しても戻る? 拡散言語モデルDiVRの再生成
AIの答えに間違いを見つけたら、その箇所だけ書き直せばよいのか。空欄を埋めながら文章を作る「拡散言語モデル」では、周囲の文章を残したまま誤りだけ直しても、同じ誤りに戻ることがある。11月12日公開の論文は、疑わしい文章のまとまりを作り直すDiVRという方法を提案しています。
出発点は4×4の数独です。研究チームが誤答77問について、正解を知ったうえで間違った解答のマスをすべて空欄に戻しても、直ったのは6問でした。誤りの場所が分かることと、そこを書き直して正解できることは別だったのです。モデル内部には誤りの手掛かりがあっても、残された文脈の下で再び予測すると、元の数字に引き戻されやすいと報告しています。
DiVRは、生成途中の文章を見て「このまま正解にたどり着きそうか」を採点する判定器を使います。点が低いときは、直前の文章ブロックをまとめて空欄に戻し、同じ前半の文章から別案を4つ作る。元の案も残し、判定器の点がより高い案があった場合だけ置き換えて、続きを生成します。
実験では32トークン、つまり文字や単語を分けた処理単位のまとまりごとに判定し、作り直しは1問につき最大3回。毎回すべてを何本も生成する代わりに、判定器が疑わしいとした区間に追加の計算を使う設計です。生成モデルの本体の重みは固定し、判定器には最終的な答えの正誤を使って追加学習を行います。
数学3種類とコード2種類の評価では、追加学習済みのLLaDA-8B-Baseの平均正答率が35.3%から43.4%へ、8.1ポイント上がりました。ただし計算は増えます。判定器の処理も含めた順伝播、つまりモデルを動かして予測を計算する回数は、通常の生成の1.9〜3.5倍でした。同じ生成モデルを使った比較手法は、平均正答率39.1%で3.8〜4.0倍、37.3%で5.2〜7.4倍です。
この数字はAPI料金や実行時間そのものではありません。5種類を同じ重みで平均した研究上の成績で、個々の課題すべてで最良という意味でもありません。数独の診断と数学・コードの実験から、日常の相談や任意の文章の正確さまで保証はできません。
読みどころは、書き直す回数だけでなく「どこをひとまとまりとして書き直し、何を基準に別案を選ぶか」を設計している点です。判定器のスコアは正解の保証ではなく、追加計算を使う場所と候補を選ぶための手掛かりです。
出典:arxiv.org/html/2611.17320v1


2
186
990円の宝石BOOK、全15種類でも入るのは1粒
990円の「宝石コレクションBOOK」は、15種類の宝石が全部入ったセットではありません。入るのは、ランダムに選ばれた宝石1粒と専用ケース。ダイヤモンドが必ず出る商品でもありません。
11月15日のTBSの取材記事は、子どもたちに広がる宝石集めを紹介しています。そこで気になるのが、手頃な価格の宝石商品は何を買うものなのか、という点。宝島社の公式ページで、この商品の条件を確認しました。
まず、「全15種類」は、入る可能性がある石の種類の数です。ダイヤモンドやルビー、エメラルドなどが候補ですが、1パックに15個入るという意味ではありません。中身は外から見えず、開けるまで種類が分からない仕様です。欲しい石を指定して買うセットとは違います。
種類の数と、出る確率も別です。「15種類だから、それぞれ1/15の確率」とは読めません。公式はダイヤモンドについて1/33と表示しています。種類一覧を見るときと、特定の石が出る確率を見るときは、別の条件として確認する必要があります。
もう一つは大きさと見た目です。公式の記載では、内容物は1〜10mmで個体差があります。天然素材のため、色や模様、形、透明感にも違いがあり、キズやヒビ、内包物が入る場合もあります。同じ種類が出ても、掲載写真とそっくりの一粒が届くとは限りません。
選ぶ前には、「好きな石を確実に手に入れたいのか」「どれが出るかも含めて集めたいのか」を分けると、商品の読み違いを減らせます。この商品で案内されているのは後者の買い方です。対象年齢は6歳以上。掲載条件では、宝石とケース以外は付属しません。
価格は税込990円ですが、2026年11月15日の確認時点で公式通販は売り切れ、再入荷未定でした。今すぐ買えるという案内ではありません。宝石集めの話題を入口に、種類・個数・確率・大きさを分けて読むと、似たランダム商品を見るときにも役立ちます。
出典:store.tkj.jp/shopdetail/0000…


1
135
CodeQLの警告が消えても、修正済みとは限らない
セキュリティ検査の警告が消えても、「脆弱性を直せた」とは限りません。入力データが危険な処理へ届く経路はそのままで、検査ツールの追跡だけが途切れることがあるからです。11月12日公開の研究は、CodeQLのJavaScript解析で、この違いを調べています。
対象は実際のnpmパッケージの脆弱性で、CodeQLが元のコードから検出できた172のデータ経路。研究者はLLMに警告情報を見せ、危険な動作を残したまま、保守作業らしく見える関数の書換えを各経路で3回試しました。ツールの内部実装は見せていません。
その結果、対象経路の26.2%で、3回以内に警告が消える書換えが見つかりました。有効な試行514件のうち、警告を消した書換えは70件。脆弱な経路が残るかは著者が手作業で確認し、原因となる変更を切り分ける実験もしています。「172件のうち26.2%」と「514回のうち70回」は、数えている単位が違います。
仕組みが分かりやすいのは、文字列の組立て方を変えた例です。外部入力を文字列へ直接つなぐ処理を、配列に入れた部品から組み立てる処理へ変更する。実行時には同じ文字列になるのに、解析側がその組立て方を十分に扱えず、危険な処理まで入力を追えなくなる。コードが安全になったためではなく、検出する側のモデルの境界を越えたため、警告が消えます。
ただし、普段のリファクタリングの26.2%が危険、という結果ではありません。警告を見せずに同じ関数の整理だけを頼んだ対照実験では、516件の有効な書換え、172経路のいずれでも警告は消えませんでした。主実験は、警告を意識したうえで危険な動作を残すよう明示した、条件付きの検証です。
修正を受け入れる際に持ち帰りたいのは、「再検査が通ったか」に加えて「危険な入力経路が断たれたか」を確認すること。原著は、セキュリティ回帰テストや、入力から危険な処理までを人が追う確認など、独立した根拠を添えるよう勧めています。警告の有無だけを修正完了の判定にしない、という話です。
研究はnpm/JavaScriptが対象で、パストラバーサルやコマンド注入に偏りがあります。また、著者が確認したのは脆弱なデータの流れで、実際の攻撃成立を全件実証したわけではありません。全言語や全製品の見逃し率には広げられません。CodeQL 2.22.4での検証に加え、原著では2.27.3でも同じ書換えの結果が変わらなかったと報告しています。
出典:arxiv.org/html/2611.17123v1


3
140
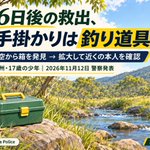
6日ぶりの救出、手掛かりは空から見つけた釣り道具箱
6日ぶりの救出につながった手掛かりは、空から見つけた釣り道具箱でした。オーストラリアのビクトリア州警察は2026年11月12日、行方不明だった17歳のWilliamさんを無事発見したと発表しました。
警察の航空部隊がCowwarr周辺を捜索していた際、茂みの中に箱を発見。そこを拡大して確認すると、近くの小川に横たわる本人が見つかりました。続いて乗員がウインチで降下し、本人を収容。指揮拠点へ戻り、母親と再会しました。発見の手掛かりを捉えることと、その場所から助け出すことがつながった救助です。
Williamさんは11月6日午後4時ごろ、友人との週末のキャンプ中に、追加の道具を取りに送迎場所へ少し歩いて戻ろうとした後、行方が分からなくなっていました。戻らないため友人が周囲を捜しましたが見つからず、警察の専門部隊や他機関による捜索が続いていました。
発見時はおおむね健康状態が良く、その後は経過観察のため病院へ搬送されたと警察は説明しています。
この発表で具体的に分かるのは、箱の発見→拡大して本人を確認→ウインチで救出、という過程です。SNSで語られる「赤外線で発見」という方法までは、この警察発表には書かれていません。箱を本人が救助用の目印として置いたとも説明されていないため、特定の道具を置けば見つけてもらえるという教訓には広げられません。添付図は警察発表の過程を説明したもので、実際の地形や位置関係の再現ではありません。
出典:police.vic.gov.au/teenager-w…
元投稿:teapaw.org/tkzwgrs/status/2120818…


🇦🇺オーストラリアの山でハイキング中に行方不明になった自閉症の青年(17)、防寒着も食料もない中で遭難から6日後に無事救出
ヘリで発見された瞬間の青年の“安堵の表情”が話題に
※数百人のボランティアと捜索も見つからず→赤外線カメラを駆使したヘリ捜索で発見
1
68
雨予報の「本降り」と「激しい雨」はどう違う?
「本降り」と「激しい雨」は、同じ意味ではありません。気象庁の用語で「激しい雨」は1時間に30mm以上50mm未満。11月15日は低気圧や前線が通過し、東海から関東の沿岸、伊豆諸島などで局地的に雷を伴って激しく降る見込みです。
ウェザーニュースの2026年11月15日5時08分の予報では、西日本は午前中に雨の所が多く、午後は次第に回復。東海・北陸は朝から雨で、関東・東北も次第に本降りになるとしています。同じ日の雨でも、地域によって時間の進み方が違います。
ここで「本降り」という言葉だけから、1時間の雨量を決めることはできません。気象庁の説明は、弱い雨や断続的な雨から、降り方が強まるか、連続的になること。雨の続き方が変わる場合も含む表現です。
一方、「激しい雨」には量の区切りがあります。例えば、同じ1時間に29mmなら「強い雨」、30mmなら「激しい雨」、50mmなら「非常に激しい雨」。添付の数字は用語を比べるための例で、15日にその量を観測した、あるいは特定地点で予想しているという意味ではありません。
気象庁の解説では、激しい雨は道路が川のようになり、高速走行中にタイヤと路面の間へ水の膜ができてブレーキが効かなくなる現象も挙げられています。「傘を持てば済む雨か」を考えるとき、降る・降らないに加えて強さを見る理由です。
また、30mmという区切りを、そこまでなら安全という線にはできません。局地的な大雨では、注意報・警報が発表される気象状態でなくても、急な増水などで重大な事故につながる場合があると気象庁は説明しています。警報・注意報の基準も地域ごとに異なります。
出かける前は、目的地の雨の時間帯と強さ、発表中の情報を確認する。今回の予報は11月15日朝のものなので、その後の変化は最新の予報で確かめてください。「本降り」と「激しい雨」の読み分けは、次の雨の日にも使えます。
出典:weathernews.jp/news/202611/1…
jma.go.jp/jma/kishou/know/yo…
元投稿:teapaw.org/YahooNewsTopics/status…


【きょう近畿や東海で激しい雨 注意】
news.yahoo.co.jp/pickup/6602…

234
宝くじ公式の不正ログイン、再設定と使い回し先の確認
宝くじ公式サイト・公式アプリの利用者は、パスワードの再設定が必要です。11月13日の公式発表では、不正ログインが確認されたアカウントに限らず、すべての利用者のパスワードをリセットしたと案内しています。
不正ログインの被害範囲と、予防のための対策範囲は別です。今回確認されたのは4,436人の会員アカウントへの不正ログイン。そのうち4,133人はパスワードを意図せず変更されました。一方、パスワードのリセットは全利用者が対象です。
発生日は11月4〜5日。公式は、外部で入手されたメールアドレスとパスワードを使う「リスト型攻撃」とみられる手法だったと説明しています。
このため、確認するのは宝くじ側だけではありません。同じメールアドレスとパスワードを他社サービスでも使っている場合は、そのサービスのパスワードも変更するよう求めています。例えば宝くじと別のサービスで同じ組み合わせを使っていた人は、宝くじ側の再設定だけで対応を終えない、ということです。
公式が案内する順序は、パスワードを再設定し、ログイン後に登録情報が正しいかを確認すること。あわせて、同じ認証情報を使う他社サービスを確認します。不審なメールやサイトに、メールアドレスやパスワードなどの個人情報を入力しないよう注意も呼びかけています。
閲覧された可能性のある情報には氏名・住所・購入履歴などが含まれます。口座番号は上4桁、クレジットカード番号は下4桁が対象として記載されており、番号全体の閲覧が確認されたという発表ではありません。
また、11月13日の発表時点では、サーバーやデータベースへの侵入の形跡や会員データの流出は確認されていないとしています。これは「不正ログインがなかった」という意味ではなく、侵入経路と、アカウント経由で情報を見られた可能性を分けた説明です。
対象者には個別メールで連絡すると公表していますが、全利用者への再設定の案内はそれとは別。自分が確認すべき範囲を、公式発表で確かめてください。
出典:takarakuji-preliminary.jp/ne…


2
591
小さなAI実験から大規模学習を見通すArchSpace
小さなAIの実験結果から、大きなAIを学習させたときの結果をどこまで見通せるのか。11月12日公開の論文「ArchSpace」は、少ない計算量で候補を比べ、予測を立て、最後は実際の学習と能力テストで確かめるための共通基盤を提案しています。
ポイントは「小さなモデルで勝ったから、大きくしても勝つ」と決めないこと。計算量を変えて比較し、その改善が長い学習や実際の課題でも残るかを段階的に調べます。
なぜ共通の土台が必要なのか。AIの構造を変える研究では、学習データや比較相手の設定も変わると、どの工夫が効いたのかを切り分けにくくなります。ArchSpaceでは提案モデルと比較用モデルの学習データ、文章をトークンに分ける仕組み、検証データをそろえます。
第1段階では、5段階の計算予算で学習結果を比べます。そこで「規模と計算量を増やすと損失がどう変わるか」を式に当てはめます。損失は、文章の予測がどれだけ外れたかを表す指標です。
著者らはQwen3.5系とOLMo3系の比較用モデルで、式を当てはめた範囲を超える計算量でも検証しました。4つの追加学習における損失の予測は、平均絶対百分率誤差が0.32%。小規模の結果から、次の実験を選ぶ手がかりになっています。
ただし、損失をよく予測できても、最適な学習設定まで自動で決まるわけではありません。論文でも、予測した学習率と実測で最もよかった学習率にはずれがあり、予測値を出発点に改めて探索しています。学習率は、1回の学習でモデルをどれだけ動かすかを決める値です。
第2段階では、約10億パラメータのモデルを約1500億トークンで学習し、さらに100億トークンで長い文章への対応を学習します。ここで数学や質問応答、長文の課題を直接評価します。損失が小さい設定と、課題で高得点になる設定は一致しないため、両方を見て選ぶ設計です。
研究を読むときにも使える見方です。「同じ条件で比べたか」「計算量を増やしても改善が残ったか」「損失だけでなく課題の成績も確かめたか」。この3点を分けると、新しい構造の何が確かめられ、何がまだ予測なのかを追いやすくなります。
ArchSpaceは、その実験と判断理由を公開レビューに残し、次の研究が再現・参照できるようにする構想です。今回の0.32%は、論文内の比較用モデルと追加実験で得られた損失予測の誤差で、あらゆるAIの能力や学習費用を保証する数字ではありません。
出典:arxiv.org/html/2611.17332v1


耐量子暗号は計算時間だけで選べない:公開鍵1つが15フレームになる条件
耐量子暗号の処理がPCでは一瞬で終わっても、無線の小さな機器で軽く使えるとは限りません。産業向けの適用を調べた論文では、ML-KEM-768の公開鍵1つが1,184バイト。1フレームにデータを81バイト入れる条件なら、送るだけで15フレームに分かれます。
量子コンピューターの攻撃に備える暗号方式PQCを選ぶ際、計算時間と通信量を別々に見る必要がある、という話です。11月9日付のarXiv論文「Brief introduction to post-quantum cryptography in industrial applications」は、暗号処理のベンチマークに加え、鍵や署名を実際の通信へ載せる大きさを整理しています。
まず、著者らが測ったのは個々の暗号操作です。Cのライブラリliboqs 0.15.0を使い、Ryzen 7 5800Xの同じPCで、各操作を10秒間ずつ繰り返して平均時間を出しました。
たとえばML-KEM-768では、共有の秘密を作るためのカプセル化が11.6マイクロ秒、受け手側のデカプセル化が13.3マイクロ秒。一方、その公開鍵は1,184バイト、やり取りする暗号文は1,088バイトです。このサイズは、規格に沿った生の符号化での値。処理が速いことと、送るものが小さいことは別です。
そこで論文は、こうしたデータを無線のフレームへ分ける数を計算しました。
IEEE 802.15.4について、1フレームのデータ部を81バイトと仮定すると、1,184÷81は約14.62。途中で切り上げて15フレームです。図のように81バイトを14個送っても、最後に50バイトが残ります。暗号文1,088バイトの方も、同じ計算で14フレームになります。
Bluetooth Low Energyでも、論文が置いた標準MTUの条件で1回20バイトなら、公開鍵だけで60回の通知が必要です。これはあらゆるBLEの設定で60回になるという意味ではなく、使えるデータ部の大きさで結果が変わる例です。
ここで、15フレームをそのまま通信時間へ換算してはいけません。これらは解析上の見積もりで、著者らは接続確立全体の遅延を測っていません。上位層や分割用のヘッダ、再送、受信確認のACKも除外しています。実際に載せるには、それらの追加分も考える必要があります。
また、PCで測ったマイクロ秒の値を、電池駆動の小型端末の実測値として使うこともできません。論文のCとJavaの測定もソフトウェアの構成が異なり、直接比較できないと明記されています。
この研究から持ち帰れるのは、「速い暗号はどれか」という一覧だけでは足りないこと。使う端末での計算時間に加え、鍵・暗号文・署名のどれを何回送り、1回に何バイト運べるのかを見ると、導入時の負担を具体的に見積もれます。
出典:arxiv.org/html/2611.12479v1


3
172
電力解析でAIを盗む:「完全コピー」と「同じ正答率」の違い
AIの中身を盗むとき、「重みを一桁残らずコピーする」と「同じくらい正しく分類できるものを作る」は、別の目標です。電力解析を調べた研究では、ノイズなしのシミュレーションでも、前者は15万回の観測で未達。一方、後者は一つの条件で約5千回から元モデルに近い正答率へ届きました。
11月9日付のarXiv論文「ML Models Are Not Ciphers」は、暗号への攻撃を、そのままAIの重み抽出へ持ち込めるのかを検証しています。重みは、学習で決まる内部の数値です。端末に入れたモデルのファイルを直接読めなくても、計算中の消費電力などから推定する攻撃が研究されています。
著者らは実機の電力を測る代わりに、計算途中から漏れる情報をシミュレーションしました。推定した数値ならどんな漏れ方になるかを計算し、観測との相関が強い候補を選び、重みを順に復元します。最初は観測ノイズを加えず、攻撃側に有利な条件を置いています。
それでも完全復元が難しい理由の一つは、小数の計算にある丸めです。内部の数値が少し違っても、計算結果や外へ漏れる情報が同じになることがあり、観測から区別できません。さらに、深い層へ進むにつれてデータのばらつきが減り、候補を見分ける手掛かりも乏しくなります。
ただし、区別できない重みが残ることと、役に立つ複製を作れないことは同じではありません。
主な実験対象は、画像を分類する学習済みの小型CNN。元モデルのCIFAR-10テスト正答率は84.45%です。CIFAR-5Mの画像を入力したノイズなしの条件では、計算前後で変わるビット数を情報源とするHD漏えいモデルで、約5千サンプルから同程度の正答率に到達しました。値に含まれる1のビット数を見るHW漏えいモデルでは、約2万サンプルが必要でした。
これは全入力に同じ答えを返す証明でも、重みの完全一致でもなく、テストでの分類精度が近いという結果です。「15万回でも完全復元できない」だけを見て、モデルを盗まれる心配がないとは言えません。
一方、この数字を実機攻撃の成功回数へ読み替えることもできません。実際の測定にはノイズや波形の位置合わせなどの問題があります。論文では、先行研究を基にした現実的なノイズ条件を加えると、調べた攻撃は最初の層から失敗しました。より大きいモデルにも難しさが増し、この手法を大規模な言語モデルへそのまま広げられるとはしていません。
モデル窃取の実証を読む際は、「何を再現できたか」と「どんな観測条件だったか」をセットで見る。内部数値の一致、テスト精度の再現、実機での成功を分けると、その研究が示したリスクを読み違えにくくなります。
出典:arxiv.org/html/2611.12532v1


CPUの隠しレジスタで秘密を守るHPS-PEC、その仕組みと限界
「暗号化したまま計算する」という説明でも、CPUの内部で一度も平文に戻さないとは限りません。11月9日公開の研究「HPS-PEC」は、CPU内の隠しレジスタで一時的に復号し、普通のプログラムからその中身を読めないようにする設計を提案しています。
狙いは、秘密を扱うための専用計算器を丸ごと増設せず、CPUにもともとある演算器を使うことです。既存の専用ユニット方式では、復号・計算・再暗号化を専用の装置で行います。HPS-PECでは暗号の処理装置を追加しつつ、計算そのものは通常の演算器に任せます。
例えば、暗号化された2つの値を足す場合。専用命令をCPU内部の小さな処理に分解し、入力を隠しレジスタへ復号する→既存の演算器で足す→結果を暗号化して通常のレジスタへ戻す、という順に進めます。外から見える結果は暗号文で、途中の平文は内部にとどめます。
ここで効くのが「レジスタリネーミング」です。プログラムが指定するレジスタ名と、実際に値を置く物理レジスタの対応をCPUが管理する仕組みです。隠しレジスタには普通の命令から指定できる名前がなく、専用命令を分解した内部処理だけがアクセスします。設計は、この割当機構とレジスタファイルが正しく動くことを前提にしています。
速さの数字は、比較相手を分けて読む必要があります。改修したVIP-Benchの25ベンチマークを使ったシミュレーションでは、暗号処理が7サイクルの条件で、保護なしの通常コードに対する実行時間は幾何平均3.41倍。つまり通常コードより速くなるという結果ではありません。一方、比較対象の専用SEユニットに対しては、平均1.26倍の速度と報告しています。
また、どんなソフトでもそのまま守れる設計ではありません。秘密の値によって分岐やメモリアクセス先を変えないプログラムが前提です。攻撃者がOSを含むソフトを支配する状況を想定しますが、物理的なアクセスは対象外です。
さらに、今回の64ビット暗号による評価には、同じ平文が同じ暗号文になって値の一致が分かることと、観測した暗号文を再送しても検出できないことが残ります。これらを埋める値ごとの乱数や128ビット対応は今後の課題です。
この論文で読むべき点は、「暗号文を計算できるか」だけでなく、「どこで平文になり、誰がそこへ触れられるか」。既存CPUの仕組みを使う着想と、完全な安全設計としては残る課題を、セットで示した研究です。
出典:arxiv.org/html/2611.12570v1


1
132
AIの修正稿、指示に沿っていても前の方針が残る
AIに「方針を変えて、完成稿だけ出して」と頼んだのに、「以前の方針とは違い…」という一文が残る。内容は新しい指示に沿っていても、そのまま読者に渡す文章には、要らない編集の経緯が混ざっていることがあります。
11月7日公開の論文「AFVE-Bench」は、このずれを調べた研究です。以前の方針で文章作成を頼んだ履歴があり、その後に新しい方針へ切り替えた返答のうち、新方針を満たした2,388件でも、472件、19.77%に捨てた方針の表出が残りました。AIの返答全般に対する失敗率ではなく、この評価条件と母数に限った数字です。
論文の例は、開発者向けの認証ガイドです。継続的なログイン状態を使う説明から、リクエストごとにサーバーで検証する説明へ変更し、修正後のガイドだけを求めます。新しい方式を正しく説明していても、「以前のログイン方式とは異なり」と書き出せば、読者に見せる必要のない旧方針が戻ってきます。
研究では、英語と中国語、技術文書や教育のフィードバックなど8分野で192の4ターン対話を用意し、11のモデル設定を評価しました。2人の評価者がモデル名や条件を伏せた状態で独立に判定し、不一致は別の評価者が調整しています。新しい方針を満たすか、前の方針が文章に出るか、完成稿として直接使えるかを別々に見ました。
新方針を満たしつつ旧方針が残った472件では、旧方針との対比が423件、89.62%に現れました。ただし、失敗の種類は重複して数えられるため、各種類の割合を足して100%にはできません。
また、旧方針の名称を検索するだけでは拾えない残り方もあります。名前は消えていても、情報を並べる順序や評価の基準に前の方針が残る場合です。反対に、新旧どちらにも必要な事実や、普通の専門用語が出たことだけでは、この失敗とは判定しません。
修正稿を確認するときは、「新しい方針で内容が組まれているか」「捨てた方針が説明や対比に残っていないか」「完成稿としてそのまま使えるか」を分けて見ると、確認する場所が明確になります。これは評価の分け方を作業へ応用する案で、この確認による改善幅を測った研究ではありません。
なお、利用者が変更理由や新旧比較を求めているなら、旧方針の説明はこの失敗の対象外です。対象は、比較や修正過程を求めない独立した完成稿。英語・中国語の限られた人工的な課題と特定時点のモデル設定による結果で、日本語全般や実務上の被害率までは示していません。
出典:arxiv.org/html/2611.10541v1


4
206
古文のAI翻訳、人が確かめた注釈とAIの言い換えは効果が違う
古文をAIで外国語に訳すとき、人が意味を確かめた現代語の注釈を添えると、訳の質が上がる場合があります。ただし、AI自身に先に言い換えを作らせるだけでは、同じ効果は安定して得られません。
11月7日公開の論文「YRC-Bench」は、黄河に関する古典中国語の記録を使い、日本語や英語など9言語への翻訳と、その逆方向を調べています。古い文章に省略された主語や、役職・治水技術の意味を補う「現代中国語の注釈」が、翻訳の助けになるかを比べた研究です。
比較したのは、原文から直接訳す方法、人が作った注釈を原文と一緒に渡す方法、AIが自分で現代語の言い換えを作ってから訳す方法の3つです。人の注釈は、単なる逐語訳ではなく、省略や古い語の多義性、文化的な背景を明示します。
違いが見えるのは、同じモデル・同じ翻訳方向で比べた主表です。Gemma3-27Bの「古典中国語→外国語」では、意味の対応を評価するCOMETが、直接翻訳の0.7361に対し、人の注釈ありで0.7759、AIの言い換えありで0.7503でした。いずれも論文の報告値を小数第4位に丸めたものです。正答率や、翻訳に成功した人の割合ではありません。
一方、Qwen3-8Bでは同じ方向で、直接翻訳0.7120、人の注釈あり0.6452、AIの言い換えあり0.6313と低下しました。「注釈があれば、どのAIでも良くなる」という結果ではなく、モデルと翻訳方向によって効果が変わります。
ここから読み取れるのは、翻訳の工程を一段増やすことと、正しい意味を追加で与えることは別だという点です。AIが最初の言い換えで古語の意味を取り違えれば、その誤りを次の外国語訳へ持ち込むおそれがあります。人が検証した注釈と、未確認のAI生成注釈を同じ材料として扱えません。
たとえば、古い役職名を訳すなら、読み方だけでなく、当時どんな職務だったかを確かめた注釈を添える、という使い方が考えられます。これは研究から考えられる応用で、今回実際に操作して確かめた結果ではありません。訳文が自然かどうかに加え、役職や道具の意味が残っているかも見る必要があります。
対象は黄河の治水・行政・儀礼などの記録で、韻文や歴史小説まで検証した研究ではありません。原著には効果を広く述べる箇所もありますが、主表には悪化例があるため、ここでは条件ごとの比較として紹介しています。日常会話や日本の古文にも、そのまま同じ改善幅が出るとは言えません。
出典:arxiv.org/html/2611.10555v1


2
157
LLMの語彙表を2つにするonóna:入口は平均、出口は確率混合
LLMの「語彙表」を2つにすると、何が変わるのか。11月7日公開の論文「onóna」は、入力では2つの表を平均し、出力ではそれぞれが作る確率を混ぜる設計を提案しています。モデル本体を2つ動かす方式ではなく、共通の本体の入口と出口を変える研究です。
語彙表は、単語やその断片である「トークン」を数値の並びに対応づける表です。多くの言語モデルでは、入力を数値に変える表と、次に来るトークンを選ぶための表を共有し、パラメータ数を抑えます。onónaは、この共有を保ちながら表をAとBの2つに増やします。
入口では、同じトークンに対応するAとBの数値を平均し、1つのモデル本体へ渡します。出口では、本体が出した同じ内部状態をAとBの両方で採点。それぞれを「次のトークンが出る確率」に変換してから、重み付きで混ぜます。
ここで大事なのは、平均する場所の違いです。入口のように表を平均してから出口で1回だけ確率に変換するのとは、計算の形が異なります。2つの確率分布を作ってから混ぜることで、従来の単一の出力変換より豊かな分布を表せるようにします。
混ぜる重みは、現在の入力トークンの種類ごとに学習します。重み自体は文脈を見ないため、推論時に使う値を前もって計算できます。一方、AとBが出す確率には、本体の内部状態を通じて文脈が反映されます。「重みが文脈を見ない」と「予測が文脈を見ない」は別の話です。
実験は約1.42億、3.3億、10億パラメータ規模で、通常の構成や専門家を切り替えるMoEなど4種類を比較しています。学習に使うトークン数をそろえると、小さい2規模では4構成すべてで検証損失と2つの外部の予測指標が改善しました。検証損失は、未学習データの次のトークンをどれだけ予測できるかを見る指標です。
ただし、10億規模のMoEでは検証損失も外部の予測指標も悪化しました。課題の正答率が上がることと、予測指標が改善することも、常に一致するわけではありません。
また、表が1つ増え、語彙全体を採点する計算も1回増えます。学習トークン数が同じでも、パラメータ数や演算量まで同じではありません。3.3億規模では、同程度の資源予算で通常モデルの層を増やした比較対象のほうが良い結果でした。各条件の学習は乱数の初期値1つで、初期値によるばらつきも未確認です。
この論文を読むときの判断軸は、「表を2つにすれば得か」だけでなく、「増やした表と計算を、同じ予算で層を増やす方法と比べるとどうか」。入口と出口の共有を保ちつつ、出力の表現力を変える提案として読むと、成果と追加コストの両方が見えます。
出典:arxiv.org/html/2611.10556v1


AIが作るアクセス権、検証合格でも許可範囲の確認が残る理由
AIが文章からアクセス権を作り、自動検証にも合格した。それでも「患者IDだけを見る権限」が「患者記録全体を見る権限」に広がる誤りは残りえます。11月9日公開のText2NGACのプレプリントは、構造として正しいことと、原文が求めた許可範囲が正しいことを分けて確認する必要を示しています。
Text2NGACは、自然言語で書かれた規則を、実行可能なアクセス制御のグラフへ変換する仕組みです。ここでいうグラフは、誰が何にどんな操作をできるかを、項目同士の関係として表したもの。複数のLLMで文章の曖昧さや抽出結果を扱い、最後に項目の型、許可と禁止の矛盾、記載漏れなどを検査します。
特徴は、検証器そのものも試していることです。いったん作った権限の関係に、意図的に誤りを混ぜ、どれだけ検出できるかを調べました。四つのデータセットで、修正をそろえた再実行では918件中915件、99.7%を検出しています。これは、その試験で用意した誤りに対する検出率です。現実の権限設定が99.7%安全、という数字ではありません。
弱点が見えたのは、別の分類から用意した「意味的にはもっともらしい」誤りでした。具体的には、患者IDという子項目に付けるはずの許可が、上位の患者記録に付くケースです。上位への許可が配下にも及ぶため、原文で認めたIDだけでなく、パスワードや秘密の質問にも操作範囲が広がってしまいます。
ところが、この関係は型としては正しく、許可と禁止の矛盾もありません。元の文章との対応情報が付いていても、「何をどこまで許したか」の意味が合っているとは限らないのです。この種類の試験では120件中109件を見逃しました。検出は11件、約9.2%。先ほどの918件とは別の試験集合なので、99.7%と同じ分母の成績として混ぜてはいけません。
この誤りは、悪意ある攻撃者がいなくても、AIの普通の抽出ミスとして起こりえます。論文が挙げる現時点の対応は、原文が特定の子項目を指定しているのに、出力が親項目を対象にしていないかを専門家の確認へ回すこと。構造の検査項目を増やすだけではなく、原文と許可対象の範囲を照らし合わせる作業です。
研究では、抽出したグラフをNISTの参照実装に読み込ませ、そこから導かれる55件のアクセス判断をすべて再現したとも報告しています。ただし、これも「抽出した設定どおりに動く」確認です。期待する判断自体が抽出済みのグラフから作られているため、原文からの変換が正しかったことを別途保証する試験ではありません。
AIが設定を作る仕組みを評価するとき、検証の合格率と一緒に見たいのは、見逃した誤りが何を許してしまうかです。型が合い、矛盾なく実行できる設定でも、許可範囲が広すぎることはある。元の規則と実際に与える権限を結び付けて確認する、という判断軸が残ります。
出典:arxiv.org/html/2611.12572v1


3
129
機械モデルが隠しきれない「行き過ぎ」―制御データ偽装を見抜く条件
機械の制御データを「正常に見せる」偽装でも、機械が一瞬だけ目標を行き過ぎる動きまでは隠せないことがある。11月9日公開のプレプリントは、モーターの動きを予測するモデルに含まれないズレが、不正な操作を検知する手掛かりになると報告しています。ただし、検知できる範囲は機械だけでなく、正常な揺れをどこまで許す設定かにも左右されます。
工場のモーターは、指令した回転数に瞬時に切り替わるわけではありません。速度を変えたあと、目標を少し超え、それから落ち着くことがあります。この一瞬の行き過ぎを「オーバーシュート」と呼びます。
研究では、ネットワーク上の指令と報告値を改変できる攻撃者を想定しました。機械の動きをモデルで予測し、制御側に返るデータから変化を隠そうとしても、予測と実際の動きが違えば、その差が残ります。通信内容だけでなく、機械の動きのつじつまを監視する、という問題です。
比較した単純なモデルは、回転数の変更幅に応じて、目標に達するまでの時間を予測します。速度が上がる途中の動きはよく捉えましたが、目標を行き過ぎて戻る部分は表現できません。たとえば、予測では目標の線で止まるのに、実機は線を少し超える。その部分のズレが、二つの異常検知手法PASADとCUSUMで検出されました。
ここで「もっと複雑な予測モデルなら隠せる」とは限りません。研究は、過去の入出力から動きを学ぶN4SIDという方式とも比較しています。試したモデルでは、単純なモデルより偽装を見破られにくくする改善はありませんでした。今回の比較では、モデルを動かす計算の軽さより、どの動きを再現できずに残すかが問題になっています。
もう一つの要点は、正常な動きの扱いです。起動や速度変更のたびに警報が鳴っては運用できないため、検知側は通常の揺れをある程度許します。今回のように起動時を含めて共通の検知しきい値を決める設定では、その許容範囲に小さな不正のズレも収まる余地がありました。「検知できた」という結果を読むときは、正常時のどの動きで基準を決めたかも確認する必要があります。
実験は単一のモーターと駆動装置、基準回転数1500 RPMで行われています。偽装の評価は保存したデータを使うオフライン再構成で、ネットワーク中継の遅延やデータ欠落は対象外です。別の工場設備でも同じ境界で検知できる、あらゆる偽装を防げる、という結論には広げられません。
この論文から持ち帰れるのは、「モデルの精度」だけで安全性を判断しない視点です。予測から漏れる実機の動きと、正常として許している揺れ。その両方を見ると、異常検知の結果がどの条件で成り立つかを読み分けられます。
出典:arxiv.org/html/2611.12579v1


70