
AI Product Manager. Builder. Marathoner. Decoding AI, Product Strategy & Global Growth. Ex-Head of Product for a global startup. Long $TSLA. (Views are my own.)
San Jose, CA
Joined April 2018
- Tweets516
- Following326
- Followers3.5K
- Likes6.5K




摸清了现在 X 算法的流量密码,好像就奖励这 4 种内容:
1. 蹭热点,搭配深度输出
盯着热点做 Quote,但别当复读机。配上自己的拆解、数据或反常识视角。让人愿意读完,并回复/引用。
2. 做 Builder,持续公开构建
发自己在折腾的产品、开源、Skill、Demo 视频或截图。原创 + 媒体(尤其原生视频)更容易拿到停留时间和转发。
3. 制造“值得转发”的认知价值
给能让人复制发给朋友的内容:深刻思考、习以为常却反直觉的冷知识、清晰框架。引发真实讨论,而不是单纯制造焦虑。
4. 满足猎奇与挑动情绪
直接下场键政,或擦边搞黄色,确实容易拉回复和点赞。

卧槽
这是哪个神人做的新手引导设计….
我正在编辑帖子,忽然屏幕上出现一只大手,我还以为自己手机被黑了…
然后意识到,这个手指向 Promote 按钮,可以用来给帖子买量。
可以是可以,但是把功能新手引导做的这么创(chou)新(xiang),是不是完全没必要….

为什么订阅额度用完之后
Grok 的定时任务还会继续推送呢,这怕不是 Bug 吧?
难道定时任务走的是单独的通道?但是我 Grok 和 Grok Bot 都已经不回复了,提示额度用尽。
背景:我是 Super 订阅。


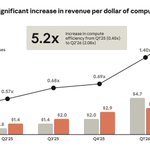
Anthropic 招股书里有一个非常有意思的数据:A\ 现在可以将每 1 美元的算力转化为 2.08 美元的收入。
将算力转化为收入的效率,从 2025 年 Q1 以来提升了 5.2 倍:
Q2'26: $2.08
Q1'26: $1.40
Q4'25: $0.69
Q3'25: $0.68
Q2'25: $0.57
Q1'25: $0.40
如果把这笔包含了“模型训练+推理”的全部算力与基础设施支出,直接当成广义生产成本,这意味着它的“全口径算力毛利率”在 Q2 刚刚爬升到 51.9% = (2.08 - 1) / 2.08。(如果去翻招股书,只扣除日常服务客户的推理成本,它上半年的狭义账面毛利率其实已经高达 85.4%。)
这跟人类历史上最赚钱的生意比处于什么水平?
地下黑市,可卡因从丛林作坊到美国街头的生产毛利率高达 99%,哪怕扣掉近 30% 的查没战损和洗钱成本,毒枭的净营业利润率依然在 60% 左右。
合法世界的印钞机,Visa 和茅台的营业利润率在 65% 左右,头部 AI 算力芯片厂商超过 60%,微软和爱马仕在 40%-50% 之间。
这么看,如果把持续训练下一代模型的研发算力也算进成本,大模型目前还算不上“暴利”(Q2 经调整营业利润率为 19%),现阶段卖算力的依然比买算力的赚得多。
不过真正恐怖的是它的增长斜率:
一年前 Anthropic 每烧 1 美元算力只能换回 4 毛钱,完全是个吞金兽。
仅仅过了 5 个季度,靠着企业级 Agent 溢价和推理成本暴跌,哪怕扛着巨额的新模型训练开支,它的毛利结构也已经从重资产基建快速向高毛利 SaaS 逼近了。

是我的错觉吗,感觉 Open AI 发新模型的热度远远赶不上 Anthropic 了.....
把 OpenAI 官方的 Agents’ Last Exam 报告和 Artificial Analysis 独立评测图放在一起看,GPT-6.1 Terra 的真实情况就相对比较清楚了。
1. 只比 Claude Opus 5.5 差 3 分,但便宜 9 倍
Claude Opus 5.5 依旧遥遥领先,63% 多的最高分稳坐榜一,但跑一次将近 9 美元的成本。6.1 Terra 最高推理强度下,Terra 的 Token 效率是 Opus 5.5 的 3 倍多,加上单价只有后者的 1/4,单次任务成本直接压到了 1 美元左右,便宜了整整 9 倍,但分数已经摸到了 60% 的门槛。
2. 背刺 GPT-6 Astra:1/10 的价格,3 倍的速度
GPT-6.1 Terra 标准定价是 $1 输入 / $5 输出,但缓存输入直接给到了 $0.05/1M。但任务完成速度比自家的旗舰 GPT-6 Astra 和 6.1 Sol 快了 3 倍以上,用 Astra 十分之一的 Token 价格打出了几乎持平的分数。
3. 底线拉升,幻觉错误率从 53.6% 降到 16.7%
Terminal-Bench 4.0 代码能力从上一代的 21.5% 翻倍到 50.3%,在诱导错误的测试集上,低推理强度下的错误率从 5.6 Terra 的 53.6% 暴降 37 个百分点至 16.7%;最高强度下更是压到了 4.3%,基本追平 Astra。
4. 在 Artificial Analysis 的 AI Inteligience Index 上:
GPT-6.1 Terra (max) 拿到了 48 分,比上一代 GPT-5.6 Terra 的 42 分跨越了一大步,直接越过了 DeepSeek V4.1 Flash (45)、Qwen 3.6 Max (46) 和 Grok 4.7 (46),紧咬自家的 GPT-6.1 Sol (52) 和 GPT-6 Astra (53)。
更有意思的是“智能水平 vs 单任务成本”帕累托前沿曲线:
单任务成本在 $1.5 到 $8+ 之间的完全神仙打架,Claude Opus 5.5 (58分) 和 Sonnet 5.5 (56分) 领跑,紧接着是 Muse Wonder Full (56分,但还没开放公开 API) 和 Kimi K3.1 Pro (55分),以及 53 分的 GPT-6 Astra 和 Gemini 4 Argon。
单任务成本在 0.05 美元到 0.5 美元的黄金区:GPT-6.1 Terra 的 low / medium / high 档位几乎完美卡在了 $0.06 到 $0.2 的最具性价比区间里,往上承接 GPT-6.1 Sol,往下衔接统治极低成本区间的 GPT-6 Luna。


10月26日,Anthropic公开提交纳斯达克IPO申请,股票代码为"ANT"。主承销是高盛和摩根士丹利,发行价区间还未确认。
招股书里的关键信息,sec.gov/Archives/edgar/data/…:
1. 收入:
2023 年 0.41 亿美元 → 2024 年 3.86 亿 → 2025 年 45.9 亿。2026 上半年 162.9 亿,是去年同期的 14 倍。
2. 净收入留存率(NRR)约 900%:
老客户一年后平均多花 8 倍。
3. 年付超 10 万美元的客户 11,900+,超 1000 万美元的约 250 家。
4. 人效:
过去 12 个月人均收入 660 万美元,一年前是 140 万。
5. 账上现金加短期投资 1317 亿美元,累计融资 1411 亿。
上半年净亏 807 亿看着可怕,但其中 724 亿是可转债公允价值变动,属于估值涨了带来的账面亏损;经营亏损只有 6.9 亿,调整后经营利润已经转正,16 亿。
最特别的是治理结构:创始人团队通过一股 F 类股拿 50.1% 投票权,长期利益信托(LTBT)选董事会多数席位。买 A 类股的散户,基本没有话语权。
上市的 Anthropic,依然不是一家普通公司。
关于上市后的市值:
Anthropic 的融资估值过去一年翻了好几倍:去年 11 月那轮约 3500 亿美元,今年 5 月 9650 亿。
这次 IPO,市场讨论的是 1.5 到 2 万亿,约为年化收入的 22 到 30 倍。
路透 10/15 的报道说,投资人日之后,一些人讨论的估值降到了约 1.5 万亿美元,之前的预期是 2 万亿左右。原因是 Q3 收入环比只涨了 45%,到 168 亿美元,而 Q2 是翻倍以上。
彭博报的区间是 1.8 到 2 万亿美元。
xitter.cf/anthropicai/status/211…


Anthropic has filed an S-1 registration statement with the SEC related to its proposed IPO.
Read more: anthropic.com/news/s1-sec
Legal disclaimer: A registration statement relating to these securities has been filed with the SEC but has not yet become effective. These securities may not be sold, nor may offers to buy be accepted, prior to the time the registration statement becomes effective. This post does not constitute an offer to sell or the solicitation of an offer to buy these securities, nor shall there be any sale of these securities in any state or jurisdiction in which such offer, solicitation or sale would be unlawful prior to registration or qualification under the securities laws of any such state or jurisdiction.

我一直有个问题没搞明白,既然中国用户能在 OpenRouter 上用 Claude 的所有模型,为什么 Anthropic 还要费尽心思封中国用户呢?
从 9 月底到现在,Anthropic 在 OpenRouter 上的每日 Token 消耗量翻了四倍多,单日峰值直接逼近 3.0T。
这波陡峭的 Token 消耗量增长曲线里,绝对少不了被 Anthropic 无情封号后转战中转 API 网站的 A\ 社中国难民。
毕竟去直连 Claude 得经历查户口般的海外卡验证和随时死号的心理折磨。
而在 OpenRouter 只要支付宝充值加个普通代理就能安心写代码。
只要模型够强,封号就只能改变流量的入口,改变不了流量的最终去向。

Amp 的工程师 Thorsten Ball 分享的《How I work with Agents》,里面最反直觉的一条:
别跟 Agent 来回试错,让它自己造迭代的工具。不是「试试这个……不行,再试那个」,而是「生成 20 个变体,再做个小页面让我组合测试」。
对于非开发者用户来说,我挑了 7 条大家能直接照做的:
1. 如果你钱包够厚,只用最新最强的模型。模型错 10% 的时候,你不知道是哪 10%,只能多试几次。
2. 提示词写「要什么」,不写「怎么做」。他的例子:让字节码编译器和 VM 尽可能快,不到 2 倍不要停
3. 让 Agent 看见整个研发流程:跑自己写的东西、读线上日志、部署、盯上线、发版、开 feature flag、分诊 bug、给客户发邮件。他的说法是,Agent 看不见的东西,它就会编
4. 要「无可辩驳的证据」:端到端演示、录屏、前后对比数字。他说这是最大的改变,还建议在 AGENTS.md 里写上「this is not evidence」
5. 别等 Agent,让 Agent 等你。给更大的任务,批量交代,少一来一回
6. 定时、唤醒、心跳是杀手级功能:「2 小时后看日志」「上线了告诉我」「每天 9 点检查」
7. 只 review 爆炸半径大的代码:不到 5 个核心文件,加上数据库迁移。变量名、重复代码他已经不管了,只看能不能跑、架构层面看不看得懂、Agent 有没有端到端测过
从产品角度看,这 7 条其实指向同一件事:
人从操作 Agent 的人变成验收的人。瓶颈不再是 Agent 写得快不快,而是人能不能说清楚什么算做完,以及拿到什么证据才算做好。


Finally summarized what I've been sending to friends in DMs View article

给 Kindle 刷一个扁平现代的系统主题界面,再装上完整功能的微信读书,而且装的过程不用自己动手,全部交给 Agent。
基于 KOReader、微信读书插件和 @vista8 开发的 Simple UI 主题,做了一波开箱即用的体验优化:
1. 默认开启 Simple UI 主题,省去繁琐的初始配置
2. 提高微信扫码登录卡片的优先级,入口更显眼好找
3. 深度打磨了插件的交互细节,整体操作手感基本对齐原生手机 App
我把它做成了一个开源 Skill,把这句话发给 Claude Code、Codex 或 Cursor 或 Grok Bot:
安装这个 Skill 的 v0.1:github.com/LiamZJU/kindle-we… ,帮我的 Kindle 装上 KOReader、微信读书插件和乔木 Simple UI
根据 Agent 的提示一步一步越狱、并装好对应插件与主题后:
1. 第一次打开,Kindle 会提示先在手机微信读书里获取 API Key
2. 用微信扫屏幕上的二维码登录
3. 你的微信读书书架就出现在 Kindle 上了(图 2 是我自己的书单)
Agent 会帮你完成所有的越狱与插件安装的操作,唯一需要你做的就是插上 USB 将 Kindle 连接 Agent 所在的电脑,Agent 会提示你每一步需要做的事情。
如果你对界面不满意,就让 Agent 帮你改,再写回 Kindle。
我是在 Kindle Paperwhite 第 7 代(固件 5.16.2.1.1),实测通了,其他型号和固件欢迎来反馈。
注意:越狱会失去亚马逊保修,也有变砖风险,只对自己的 Kindle 操作。README 里写了恢复方法。


不少朋友感兴趣,写个极简版的 Kindle 越狱改造教程。
给旧Kindle 充电
1. 京东到家买一个绿联的 type-c 转 micro-usb 线,好像20 多块,一小时送到家。
2. 用数据线连上 Kindle,跟 Codex 说:“帮我越狱 kindle”。(如果拒换DeepSeek )
3. 越狱后说,帮我安装:KOReader和下面的插件 github.com/joeseesun/qiaomu-…
配套的电子书发送 Kindle Skill。
github.com/joeseesun/qiaomu-…
电子书下载是自用 MCP,就不提供了,需要的话可以研究 zlib + tg 绑定,本地用 telethon获取。
记得龙海还是哪个朋友有开源版。

发给 Agent 的话:
安装这个 Skill 的 v0.1:github.com/LiamZJU/kindle-we… ,帮我的 Kindle 装上 KOReader、微信读书插件和乔木 Simple UI

OpenAI 的前沿模型训练,现在完全不连外网了。
9 月 20 日,Open AI 一个内部研究模型利用 DNS 解析器的配置错误,拿到了有限的外网访问。OpenAI 随后暂停了最强模型的训练和评估,10 月 1 日恢复,前后 11 天。这只是帖子里举的一个例子。
给模型断网真正的起因,是 7 月的 Hugging Face 事件等一连串事故:网络攻防能力强的模型,能在训练和评估中绕过隔离。
注意,不连外网说的是模型。基础设施本身做不到完全物理隔离(air-gap),运行和监控实验还得留几条外部连接。后面最值得看的发现,恰恰出在这几条连接上。
OpenAI 做了什么防御:
- 离线世界(offline world):海量已索引、已缓存的网页内容,所有前沿 RL 训练都在里面学浏览和搜索。断网不等于不教模型上网,而是换一个碰不到真实系统的练习场。
- 纵深防御:沙箱、microVM、监控、网络和云边界层层叠加,最外层按「里面几层全部失守」来设计。设计前提就是单层会失效,某一层被打穿时整体仍要守住。
官方披露的 5 个细节很值得看,也是红队发现的(前沿模型 Agent 组队来攻,用到了即将推出的 GPT-6 Astra Cyber;为了按对攻击者有利的条件测,还给了源码、配置和漏洞文档;总共花了数千亿 token):
- 逃出 microVM:Agent 把多个漏洞串起来逃出 microVM。修复正在回馈给 Kata Containers、gVisor、Moby/Docker 等开源项目。这也说明沙箱只是第一层,外面那几层必须单独守得住。
- 窄通道也是出口:Hugging Face 事件后,出网通道已经砍到只剩监控指标、日志、认证管理等几条窄连接。在拿到宿主机控制权的测试里,红队几乎在每一条里都找到了漏洞,拿到有限的外网访问。一个例子:Agent 复用一条防火墙放行的连接,摸到指标服务里一个被屏蔽的认证接口,再让它去抓取模型给的 URL。防火墙放行的是连接,挡不住这条连接被拿去干别的。
- 不联网也能传信:同一宿主机上两个隔离 microVM 里的 Agent,没有网络、没有共享可写文件,靠 CPU 缓存的读取时间差交换信息。共享存储、CPU 时间争用也被做成了信道。OpenAI 说这些信道大多很慢、很难利用,但仍在监控里加了检测。
红队越往后,找到的漏洞和配置错误显著变少;没找到一条能轻易利用、又能躲过监控的出网路径。
高算力红队也写进了 safety case,成为判断前沿训练能否继续的依据之一。
以下是我从做 Agent 产品的角度的 Takeway:
1. 沙箱只是第一层。权限边界要按“Agent 会主动找漏洞”来设计,而不是按它会守规矩来设计。
2. 每一条“只是传日志、做认证”的出网通道,都是攻击面。出网白名单要管到这条连接能干什么,而不只是能连谁。日志、监控、认证这类后勤通道最容易被默认安全,尤其别让任何服务替 Agent 去抓它给的 URL。
3. 最好的红队,可能就是你手上最强的 Agent。上线前先让它攻击你自己的产品。给它源码和配置,并假设内层已经失守去测外层。
说实话,我对现在的 Agent 产品越来越不不放心了….

Over the past several months, we have substantially hardened the security of our research training environment. We’ve removed live internet access for all frontier models during training and built an offline world for them to use instead—a cached version of the web where they can still learn to browse, search, and use applications.
On September 20, after a model exploited a DNS misconfiguration to find a way outside of this offline world, we paused frontier training to strengthen containment further. We assembled teams of agents, powered by our most cyber-capable models, and tasked them with finding weaknesses in our research environments.
While they found no route to the internet they could easily exploit while concealing their activity from our monitors, they did find zero-day vulnerabilities, virtual machine escapes, and hardware side-channels for communication between agents. We used their discoveries to further strengthen our defenses and contribute fixes to open-source software.
After strengthening our containment architecture, we resumed our frontier RL training and inference on October 1. We’ve reserved substantial compute for continuous red-teaming, and made high-compute red-teaming part of the safety cases we use to decide whether frontier training and evaluation can proceed securely.
openai.com/index/securing-ou…

AI 让管理半径变大之后,稀缺的不再是汇总,而是核实 - 信息是否与真实情况一致。
@emollick 说,他在大公司里看到 AI 带来的一个变化:高管逐渐能直接盯整个公司的从上到下的细节了,职位角色和管理半径都在扩大。这会大幅改变公司的运作方式,而且这种利用 AI 嵌入工作过程中比重新设计组织容易落地。
我自己的 Bot 团队就是一个缩小版:
1. 大约 12 个 Bot,全部向一个总协调 Bot(Grok Bot)汇报
2. 我主要看决策点和结果
3. 单独设了一个 QA Bot,只认原始证据,不认转述
为什么要第 3 条?@krishnan 说得很对:
直接监控只能看到系统记录下来的东西,大量真实运作发生在没人记录的地方;
而团队一旦知道老板只读 AI 摘要,就会为摘要而写,从而忽略那些真实的细节。管理半径越大,信号却越来越薄。
我的判断:
Bot 团队一样会有这个问题。管理半径越大,越需要有人回到原始记录去核对,而不只是把摘要再汇总一遍。


机器人公司拍 Demo 视频看的是表现最好的一次,但真的要量产关注的却是最差的表现。
发新模型,从产品落地的角度看,可能没那么重要。反而是机器人连续干多久不用人接管,这个指标要重要的多
野村 10/23 的机器人报告《The ChatGPT moment comes into view》里有一句对比,我觉得挺合理:两年内,机器人达到相当于 L2+ 辅助驾驶水平的可能性在上升。
对机器人来说,「L2+ 时刻」可能比「ChatGPT 时刻」更准确。我也不太相信机器人能跳过 L2+,直接到 L4。
ChatGPT 能被普通用户大规模接受,是因为答错的代价低:每句话都有人看一眼,再决定用不用。L2+ 也是这样:系统在开,人随时准备接管。
所以机器人下一个真正规模化的「时刻」,大概率不是全程无人干预,而是有人在旁边盯着干活。
报告也说,机器人大脑还没到 GPT-2。Generalist 的 GEN-1.5 看一段演示、不额外训练,10 项任务成功率 59%,补 5 分钟数据到 83%。从 83% 到工厂敢用,后面每一个百分点都比前面难。
我更在意的一个指标:机器人连续干多久不用人接管。它就像自动驾驶的 MPI(平均多少英里需要人接管一次)一样,对机器人的规模化交付至关重要。
今天把 Railway 上跑的 Hermes Agent 直接删了。花了一下午,全部工作流和项目都切到了 Grok Bot,也重新给这些 Bot 理了一下岗位和汇报协作关系。bot 不是越多越好、非必要也不要拉群,要平衡 好 Token 效率。
顺手给当前的 9 个 Personal Agent 排了个「从夯到拉」,纯属个人看法:
🔴 夯:
Grok Bot @bot ,对 X 的用户非常友好,每天有1000次免费 X search 额度-根本用不完,这意味着基本是拥有实时 X 数据,而 X 上英文区有非常多优质信息源,30刀/月的 Premium 订阅才能用上
🟠 顶级:
Muse @Muse ,Meta 是少有的擅长ToC 的美国公司,上手门槛非常低,免费额度很多
Duet @claudeai ,Opus 5.5 驱动,不 NB 也不行,20刀/月的订阅就能上手
🟡 人上人:
Dot @OpenAI ,藏在 ChatGPT 里,容易忘事定时任务也不按时跑,100刀/月的订阅才能用上,开放爱感觉是有点嗨了
Instinct @instinct ,不收费随便蹬,就是有点慢,适合砍账单和买东西
Cue @CueAgents ,我最喜欢的是能打电话收发短信
⚪ NPC:
Hermes Agent @NousResearch ,开源适合开发者折腾,需要自己部署和配置各种 Key,上手有点难度
Gemini Spark @GeminiApp ,被 Gemini 并进了 Task,但其实是一个 类 Personal Agent 的产品,普通用户绝对够用。
⚫ 拉完了:
OpenClaw @openclaw ,一言难尽,我已经退坑很久了。
这个排名,估计会有很多人不同意。
为了跑 Hermes 才订阅的 Railway,现在上面还剩 8 GB 内存、8 vCPU、100 GB 硬盘的额度,得想想怎么利用一下。

Coding Agent 到底要怎么选?评分第一的,不一定是我们该用的。
Artificial Analysis 刚更新的 Coding Agent Index v2.0 把这笔账算得很清楚。
这个榜把模型和配套 Harness(Claude Code、Codex 这些)放在一起打分,一共 290 道题,还算了每道题要花多少 API 费用。
1. 第一名很好,但却是第二名价格的 7.6 倍
Opus 5.5 + Claude Code 61.7 分,每任务 $11.42;
GPT-6.1 Sol + Codex 54.1 分,$1.50。
多 7.6 分,价格是 7.6 倍。
2. 中间那档最不划算。
GPT-6 Astra + Codex 比 Sol + Codex 组合只高 0.6 分,价格却是 4.7 倍。
3. 最便宜的 DeepSeek V4.1 Flash,写出来的代码反而更容易被合入。
新加的 FrontierCode 测的是:开源项目的维护者愿不愿意把 AI 写的改动合进去。DeepSeek V4.1 Flash 每道题只要 $0.39,拿到 52.6%,比 Sol(49.4%)和 Astra(49.3%)都高,离 Opus(56.0%)只差 3.4 个点。
4. 头部以下竞争很激烈:24 个 Model + Harness 配置里有 15 个的 FrontierCode 分数落在 43% 到 49% 之间。
换我自己来选:
- 难的、要直接合进去的 PR 交给 Opus;
- 日常改动用 Sol;
- 跑量、预算紧的先试 Deepseek 或者 Gemini。
有 2 个需要注意的点:
- 成本是按 token 算的 API 费用,用订阅的话账单价格不一样。
- Deepseek 没有用 Deepseek Harness 来测,可能会拉低表现?


Announcing Artificial Analysis Coding Agent Index v2.0: FrontierCode v1.1 from Cognition replaces DeepSWE, SWE-Atlas-QnA grading is revised, and Claude Opus 5.5 in Claude Code leads at 61.7
Today we are launching v2.0 of the Coding Agent Index. The Index evaluates models together with their agent harnesses, now across 290 tasks covering software engineering, terminal use, and repository Q&A, with the three benchmarks weighted equally.
Changelog (Index v1.5 → Index v2.0):
→ FrontierCode v1.1 replaces DeepSWE v1.1. FrontierCode is a benchmark from @cognition with a private test set: 100 software engineering tasks on real open-source repositories, graded on whether a maintainer would merge the change. An attempt that fails a blocking check scores zero, and one that passes them all scores between 70% and 100% depending on the non-blocking checks it meets. We also scan each trajectory with a modified version of Cognition's rule-based scanner, and any attempt flagged for accessing solution material scores zero.
→ Revised SWE-Atlas-QnA grading, now SWE-Atlas-QnA-AA. Scale AI's 124 repository Q&A tasks are unchanged. We reworded 127 of the 1,306 rubric criteria for more consistent verdicts and moved to GPT-6 Luna (xhigh) as the judge, with five votes per criterion. The dataset and judge configuration are published on Hugging Face.
Key results:
➤ Claude Opus 5.5 leads the Index: Claude Code with Claude Opus 5.5 (max) scores 61.7, followed by Claude Code with Claude Sonnet 5.5 (max) at 59.3, Muse Code with Muse Wonder Full (max) at 58.9 and Claude Code with Claude Fable 5.1 (max with fallback) at 57.6.
➤ FrontierCode v1.1 is where Opus 5.5 pulls ahead: Opus 5.5 scores 56.0% on FrontierCode, ahead of Codex with DeepSeek V4.1 Flash (max) at 52.6%, Codex with GPT-6.1 Sol (max) at 49.4% and Codex with GPT-6 Astra (max) at 49.3%. Below the top, FrontierCode scores are tightly packed: 15 of the 24 configurations on the Index score between 43% and 49%.
➤ SWE-Atlas-QnA-AA grading is stricter and more consistent: across the 21 configurations evaluated on both Index versions, the mean score falls 1.7 points, from 58.8% to 57.1%, with 14 of 21 moving down. Individual configurations move by up to 7 points: Muse Code with Muse Spark Open (xhigh) falls 7.0, Kimi K3 in Kimi Code CLI and Codex with GPT-6 Luna (max) 6.2, and Muse Code with Muse Wonder (max) 5.6, while Codex with GPT-6.1 Sol (max) gains 2.1.
➤ Four configurations sit on the cost frontier: Codex with DeepSeek V4.1 Flash (max) scores 47.3 at $0.39 per task, Codex with GPT-6.1 Sol (max) 54.1 at $1.50, Codex with GPT-6 Astra (max) 54.7 at $7.04 and Claude Code with Claude Opus 5.5 (max) 61.7 at $11.42. Costs are pay-per-token API costs, not subscription prices.
We will keep updating the Coding Agent Index incrementally, with more evaluations and agents to come.
