

AIにすっかりハマって、もう離れられなくなりつつある人。気になったものは自分で試して検証中。国内・海外の最新動向に注目。
日本 / Tokyo
Joined May 2026
- Tweets137
- Following158
- Followers88
- Likes273




Pinned Tweet
Qwythos-9B-Claude-Mythosを、VRAM 6GB環境で動かしてみました。
今回は llama.cpp / llama-server で、通常版の Q4_K_M / Q5_K_M / Q6_K を比較しています。
見た内容はこのあたりです。
起動できるか
VRAM使用量
生成速度
日本語文章作成
要約
コード相談
簡単なHTMLゲーム生成
Claude Mythos系っぽさ
ざっくり結果は、
Q4_K_M: かなり現実的
Q5_K_M: 6GBでも候補になる
Q6_K: 起動はするが普段使いには重い
という印象でした。
Q4_K_MはVRAM 4GB台で動く話にもかなり現実味があります。
ただし、今回の実機はVRAM 6GBなので、4GB実機で確実に動くとまでは断定していません。
少ないVRAMで9BクラスのGGUFを試したい方には、かなり面白いモデルだと思います。
興味ある方はリプ欄へどうぞ。
#Qwythos #llamacpp

NVIDIAの音声認識モデル Nemotron 3.5 Transcribe、Artificial AnalysisによるとWER 2.8%でオープン音声認識の同率1位
・総30B/アクティブ4BのMoE(Artificial Analysis)
・40言語対応、重みはHugging Faceで公開(NVIDIA発表)
アクティブ4Bなら手持ちのでどこまでいけるか、気になるね。

NVIDIA's Nemotron 3.5 Transcribe ties for #1 among open weights Speech to Text models with 2.8% WER, using just 4B active parameters
Nemotron 3.5 Transcribe is NVIDIA's new open weights Speech to Text model for non-streaming transcription, with 30B total and 4B active parameters, and the most accurate NVIDIA model on our non-streaming Speech to Text leaderboard.
Key takeaways
➤ Accuracy: Nemotron 3.5 Transcribe scores 2.8% on the AA-WER Index, tied with Mistral's Voxtral Small for #1 among open-weight models. It leads Voxtral Small on AA-AgentTalk, our dataset of voice agent conversations, at 1.8% vs. 2.3%.
➤ Model size: With 4B active parameters (30B total), Nemotron 3.5 Transcribe sits on the open weights frontier of AA-WER vs. active parameters. It matches the accuracy of Mistral's Voxtral Small with 6x fewer active parameters (4B vs. 24B), while other open weights models of a similar size sit at around 4% WER.
Congratulations to @NVIDIAAI on the release!
See more details below ⬇️

拡散LLMでSWE-bench 73.6(公式値)
Clover-35B-A3Bの680 tok/sはGB300・BF16での数字で、BF16重みは約69GB。llama.cpp対応はあるので、12GB勢は量子化待ち

Meet Clover-35B-A3B-Preview 🍀 the first open-weight production diffusion language model (dLLM) with 35B total parameters capable of 680 tps on a single card at BF16.
Clover exhibits strong performance against both dLLM and AR models and is available today at @huggingface @ModelScope2022 and at our website


GitHubのCopilot Fusionが正式版に。
モデルは自分で選ばない。「がんばり具合」だけ選ぶと、Copilotが複数モデルを組み合わせるらしい。
ベンチでは60点で3番目。1位と2点差、コストは約半分だそうだ。
モデルを選ぶ仕事が減って、力の入れ具合を選ぶ仕事が残った。

Liquid AIのLFM3、10/27に6モデルいっぺんに出た。
全部1.7Bベース。テキスト版は4bit約1GB、コンテキスト256K。
でも公式モデルカードに、agentic codingや複雑な推論は非推奨と明記。
小さいモデルは万能狙いより、決まった仕事専用が正解な気がする。
huggingface.co/LiquidAI/LFM3…

Ollamaに音声生成が来た。Phononってやつで、チャットの返答をそのまま読み上げてくれるらしい。
ていうか、またMacか。
Apple Siliconのみ、Windowsは「近日」で日付なし。しかも対応言語に日本語がない。
Windowsに来ても、喋れない。

今さらだけど、Claude Codeの /btw 使ってみたら、かなり快適。
作業を止めずに横から聞けて、答えは本題の履歴に残らない。
ファイルは新しく読まないので、聞けるのは「この会話でもう出てきたこと」だけ。


Codex CLI、よく使う指示は /presets に保存して呼び出せる(0.164.0から)。
毎回コピペする長い指示の置き場によさそう。
github.com/openai/codex/rele…

ローカルLLM用のProject Maya、DeepSeekの高速化はLinux+NVIDIA GPUの1枚構成向け。
Windowsは今までの処理のままなのね。

ALT Project Maya v1.1.28 のリリースノート。DeepSeek の生成の高速化は Linux の NVIDIA GPU 1枚構成が対象で、Windows・AMD・複数GPUは従来の処理のまま、という記載
v1.1.28の変更。PCのRAMにエキスパートを置く場合の生成処理が対象です。Windows・AMD・複数GPUは従来の処理経路で、プロンプト処理速度は変わらないとのこと。手元では未検証。
github.com/mw00/project-maya…

VRAM 6GB+RAM 32GBのPCで、国産LLM「LLM-jp-4.1」の32B-A3B(MoE)が約18 tok/s出た。
GPUに一部しか載らない8B(12.5〜15.8 tok/s)より速い。エキスパートをCPU側に置くのがコツでした。

ALT VRAM 6GB・RAM 32GBの同じPCでのLLM-jp-4.1の生成速度(文脈設定4096〜16384、各3タスク)。CPU併用の32B-A3Bは17.5〜18.7 tok/s、一部をGPUに載せた8Bは12.5〜15.8 tok/sで、32B-A3Bが速い
6GBの落とし穴。
うちのPCは画面表示も同じGPUで、llama.cppを動かす前から0.9〜1.5GiB使われていました。
6,144MiBを全部使える前提で層数を決めると、エラーは出ないまま共有GPUメモリの使用量が増え始める。
起動前に nvidia-smi で使用量を見ておくのがおすすめです。
起動はこれ(6GB・文脈16384)。
llama-server -m llm-jp-4.1-32b-a3b-thinking-Q4_K_M.gguf -ngl 99 --n-cpu-moe 30 -c 16384 --parallel 1 --jinja -fa on
RAMは32GBで動いたけど、空きは最小約1.1GiBまで減りました。
動かし方のメモはZennにも:
zenn.dev/localai_lab/article…

公式GGUFは24GB向けのMuse Glimmer 30B(Meta)、
RTX 4070(12GB)でもunslothの2bitなら全層GPUに載って38 tok/s 出た。公式4bitの約10倍。

ALT RTX 4070 12GBでのMuse Glimmer 30Bの生成速度。短い3タスクの平均は、unslothの2bit(全層GPU)が37.9 tok/s、Meta公式4bit(一部CPU)が3.75 tok/sで約10倍。答えまでは思考込みで2bitが約9〜15秒、公式4bitが81〜108秒
公式4bitで変なことがひとつ。
GPUに載せる層を34→36に増やすと、プロンプトを読む速さが 438.9 → 68.4 tok/s。約6.4分の1。
なのに、書く速さは38層が最速(llama-benchで試した中で)。
読む速さと書く速さで、速い層数が違う。エラーは出ません。
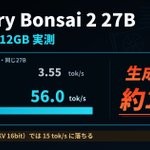
ローカルLLMの話。RTX 4070(VRAM 12GB)で27Bクラスのモデルを動かす実測です。
4bit版のQwen3.8-27Bは12GBに載りきらない。生成3.55 tok/s。
待てなくはないけど、対話には遅い。
同じモデルを約2bitの三値に縮めた Ternary Bonsai 2 27B に替えたら、
全層がGPUに載って 56 tok/s。約16倍でした。
品質は、同じ3タスクを並べて明確な差なし(各1回・思考オフ)。
「27Bには24GB」は、このモデルには当てはまりませんでした。

数字と手順はここにまとめました。
llama-benchとllama-serverの両方の速度、同じ3タスクの出力の比較、
文脈枠を32K〜128Kまで広げたときの速度の変化。
ひとつ注意。通常のllama.cppでは動かない。PrismML版が要ります(記事にリンクあり)。
localailab.org/ternary-bonsa…
